llms.txt: Hype-Datei oder echter Hebel für KI-Sichtbarkeit?
In fast jeder Diskussion über Sichtbarkeit in ChatGPT, Perplexity oder den Google AI Overviews fällt früher oder später dieselbe Frage: Brauche ich eine llms.txt? Tool-Anbieter und Plugins bewerben die Datei inzwischen als Pflichtbaustein für Generative SEO. Die verfügbaren Daten zeichnen ein anderes Bild. Kurzfassung: Anlegen schadet nicht, aber erwarte davon keinen messbaren Effekt.
Was llms.txt eigentlich ist
Die Idee stammt von Jeremy Howard (Answer.AI) und wurde im September 2024 veröffentlicht. Wichtig ist der Status: llms.txt ist ein Vorschlag, kein verabschiedeter Standard. Es gibt kein Gremium, das ihn pflegt, und keinen großen Anbieter, der sich verbindlich zur Unterstützung verpflichtet hat.
Das Prinzip ist simpel. Im Root der Domain liegt eine Markdown-Datei unter /llms.txt. Sie beschreibt in wenigen Sätzen, worum es auf der Website geht, und verlinkt auf die wichtigsten Inhalte, idealerweise auf Markdown-Versionen der Seiten. Ein Sprachmodell soll so schneller erfassen, was relevant ist, ohne sich durch Navigation, Cookie-Banner und Skripte zu arbeiten.
Eine minimale Datei besteht aus einer H1 mit dem Namen der Website, einem kurzen Zitatblock als Zusammenfassung und einer oder mehreren Linklisten unter H2-Überschriften, etwa „Leistungen“, „Artikel“ oder „Über uns“. Jeder Eintrag enthält einen Link und optional eine Kurzbeschreibung. Ergänzend sieht der Vorschlag eine llms-full.txt vor, die den vollständigen Text der wichtigsten Seiten in einer einzigen Datei bündelt. Plugins für WordPress und gängige Website-Baukästen erzeugen beide Dateien inzwischen per Klick.
Auf dem Papier klingt das vernünftig. Der Haken: Ein Vorschlag entfaltet nur dann Wirkung, wenn die Systeme, für die er gedacht ist, ihn auch tatsächlich nutzen.
Was die Logdaten zeigen
Die Verbreitung wächst schnell. Laut einer Auswertung von Originality.ai stieg die Zahl der Websites mit llms.txt zwischen Juni 2025 und Mai 2026 von 4.088 auf 36.120. Das ist ein Anstieg um das 8,8-Fache.
Die Nutzung hält damit nicht Schritt. Ahrefs hat die Serverlogs von rund 137.000 Domains ausgewertet. Das Ergebnis: 97 % der llms.txt-Dateien wurden im Mai 2026 kein einziges Mal abgerufen. Und wenn doch, dann kamen die Abrufe überwiegend von SEO-Audit-Tools, die prüfen, ob die Datei existiert. Auf KI-Retrieval-Bots, also die Crawler, die Inhalte für Antworten in Echtzeit holen, entfiel nur rund 1,1 % der Abrufe.
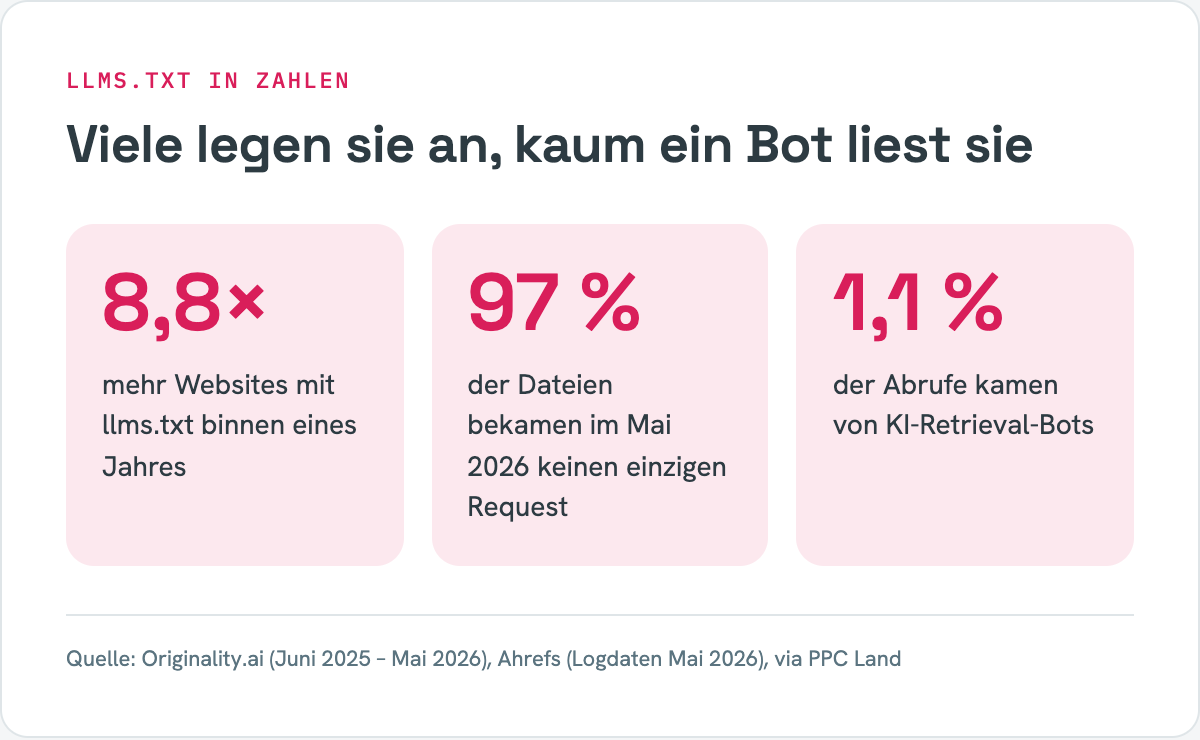
Mit anderen Worten: Die Datei wird vor allem von den Werkzeugen gelesen, die ihre Einrichtung empfehlen. Die KI-Systeme selbst ignorieren sie weitgehend.
Was Google sagt
Von Google gibt es eine klare Aussage. John Mueller schrieb im Juni 2025 auf Bluesky: „No AI system currently uses llms.txt.“ Gary Illyes ergänzte, dass Google die Datei nicht unterstützt und das auch nicht plant. Für die AI Overviews gelte normales SEO: Was in der klassischen Suche gut indexiert und relevant ist, hat auch dort Chancen.
Das Grundproblem liegt im Konzept. llms.txt ist eine Selbstauskunft des Website-Betreibers. Suchmaschinen haben Selbstauskünften noch nie vertraut, weil sie sich leicht manipulieren lassen. Die Parallele zum Keywords-Meta-Tag liegt nahe: Auch dort durften Betreiber selbst angeben, worum es auf ihrer Seite geht. Google hat das Signal schon vor Jahren aufgegeben, weil es mehr über die Absichten des Betreibers verriet als über die Qualität der Inhalte.
Hinzu kommt: KI-Systeme haben längst eigene Crawler, die HTML lesen, rendern und auswerten. Für sie gibt es wenig Grund, sich auf eine zusätzliche, ungeprüfte Zusammenfassung zu verlassen.
Was stattdessen wirkt
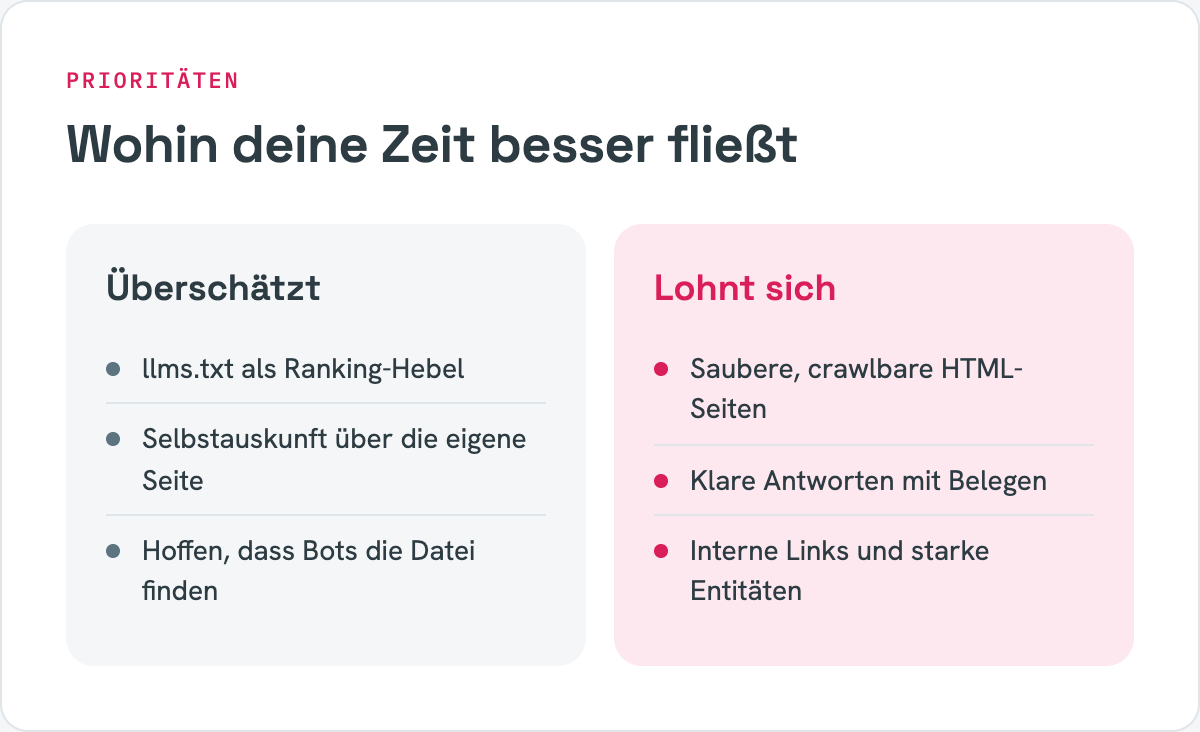
KI-Systeme zitieren, was sie auf deinen HTML-Seiten finden, nicht das, was du ihnen in einer Begleitdatei versprichst. Wer in KI-Antworten auftauchen will, sollte seine Energie deshalb in drei Bereiche stecken:
- Crawlbarkeit ohne Hürden: Zentrale Inhalte müssen im HTML stehen und dürfen nicht erst per JavaScript nachgeladen werden. Viele KI-Crawler rendern kein JavaScript.
- Zitierfähige Antworten: Klare Aussagen, konkrete Zahlen und nachvollziehbare Quellen machen eine Seite zur bevorzugten Fundstelle. Ein Absatz, der eine Frage direkt beantwortet, wird eher übernommen als ein langer Einleitungstext.
- Interne Verlinkung mit Profil: Links zwischen thematisch verwandten Seiten zeigen, wofür eine Website steht und auf welchen Gebieten sie Autorität besitzt.
Genau hier setzt auch das Generative Authority Model an: Sichtbarkeit in generativen Systemen entsteht aus belastbaren Inhalten und erkennbarer thematischer Autorität, nicht aus Metadateien.
Fazit: anlegen, abhaken, weitermachen
Eine llms.txt ist in zehn Minuten angelegt und richtet keinen Schaden an. Wer sie haben möchte, kann sie einrichten. Als Hebel für KI-Sichtbarkeit taugt sie nach heutigem Stand aber nicht. Die Logdaten zeigen kaum Abrufe durch KI-Systeme, und Google hat eine Unterstützung ausdrücklich ausgeschlossen.
Sollte sich das ändern, etwa weil ein großer Anbieter die Datei offiziell auswertet, lässt sich schnell nachziehen. Bis dahin gehört die Zeit in Seiten, die KI-Systeme tatsächlich lesen und zitieren.
Quellen
- PPC Land: llms.txt adoption rises 8.8x but 97% of files get zero AI requests
- Search Engine Roundtable: Google – No AI System Currently Uses LLMs.txt
- Search Engine Land: Meet llms.txt, a proposed standard for AI website content crawling
- Search Engine Land: Google says normal SEO works for ranking in AI Overviews and llms.txt won’t be used

Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).