Prompt Engineering für Einsteiger: So formulierst du gute Prompts
Viele Antworten von KI-Tools klingen solide und gehen trotzdem am Ziel vorbei. Der Grund liegt selten im Modell, sondern meist in einer Anweisung, die zu wenig über Aufgabe, Zielgruppe und gewünschtes Ergebnis verrät.
Prompt Engineering setzt genau dort an. Der Ansatz übersetzt ein Ziel in Anweisungen, mit denen Sprachmodelle verlässlich arbeiten. Das wird wichtiger, weil Reasoning-Modelle anders auf Anweisungen reagieren und Menschen KI-Systeme heute wie Suchmaschinen befragen.
Prompt Engineering gehört zum Feld des Promptings, das untersucht, wie Anweisungen das Verhalten von Large Language Models steuern.
In diesem Artikel erfährst du, aus welchen Bausteinen ein guter Prompt besteht, welche Techniken es gibt, wie du Prompts schrittweise verbesserst und was Reasoning-Modelle, Context Engineering und AI-Search daran verändern.
Was ist Prompt Engineering?
Prompt Engineering ist das gezielte Formulieren von Anweisungen (Prompts) an ein Sprachmodell (Large Language Model wie GPT, Claude oder Gemini), damit es eine Aufgabe in der gewünschten Qualität und Form löst. Prompt Engineering übersetzt ein Ziel in Kontext, Vorgaben und Beispiele, die das Sprachmodell eindeutig auswerten kann.
Ein Prompt ist jede Eingabe, die ein Sprachmodell verarbeitet: eine Frage, eine Arbeitsanweisung oder ein ganzes Briefing mit Material. Prompt Engineering macht aus dieser Eingabe ein Werkzeug, das wiederholbar zum gewünschten Ergebnis führt. Entscheidend ist dabei weniger Technik als Klarheit über das eigene Ziel.
Zwei Begriffe liegen nah am Prompt Engineering. Instruction Design gestaltet Anweisungen so, dass sie dauerhaft und für viele Nutzer funktionieren. Context Engineering erweitert den Blick über den Prompt hinaus auf alles, was ein Sprachmodell beim Antworten sieht.
| Merkmal | Prompt Engineering | Context Engineering | Instruction Design |
|---|---|---|---|
| Gegenstand | einzelne Anweisung | gesamter Kontext des Modells | wiederverwendbare Anweisungsstruktur |
| Reichweite | eine Aufgabe | viele Schritte eines Agenten | viele Aufgaben und Nutzer |
| Typischer Einsatz | Arbeit mit einem KI-Tool | KI-Agenten und KI-Anwendungen | Teams und produktive KI-Systeme |
| Ergebnis | passende Antwort | stabiles Verhalten über viele Schritte | gleichbleibende Qualität |
Sprachmodelle brauchen klare Anweisungen
Sprachmodelle verstehen Aufgaben nicht so, wie ein Kollege sie versteht. Sie werten nur den Text aus, den sie erhalten, und ergänzen den Rest nach Wahrscheinlichkeit. Drei Eigenschaften erklären, warum die Anweisung über die Qualität der Antwort entscheidet.
Sprachmodelle füllen Lücken mit Wahrscheinlichkeiten
Sprachmodelle füllen fehlende Angaben mit der wahrscheinlichsten Fortsetzung. Ein Large Language Model erzeugt Text Token für Token und wählt dabei, was nach seinen Trainingsdaten am besten passt. Fehlen im Prompt Zielgruppe, Zweck oder Rahmen, nimmt das Modell den häufigsten Fall an.
Ein Mensch würde in dieser Lage nachfragen oder auf gemeinsames Vorwissen zurückgreifen. Ein Sprachmodell kennt weder deinen Stil noch deine Kunden noch den Zweck des Textes, solange diese Angaben nicht im Prompt stehen.
Das gilt auch für Fakten. Was das Modell nicht weiß, ergänzt es plausibel statt richtig. Wie Systeme Antworten deshalb an abgerufene Quellen binden, beschreibt der Artikel zu Grounding in der KI.
Vage Prompts erzeugen Durchschnittstexte
Vage Prompts erzeugen Texte, die zu allen passen und deshalb niemandem helfen. Die Anweisung „Schreibe einen Artikel über Content-Erstellung mit KI“ liefert einen soliden Überblick, wie er auf jeder Agenturseite stehen könnte. Das Modell hat nichts falsch gemacht. Es hat die allgemeinste Lösung für eine allgemeine Aufgabe gewählt.
Ein präziser Prompt verschiebt das Ergebnis. Nennt er Zielgruppe, Tonalität, Länge und Zweck, entsteht ein Text für genau diese Situation.
Der Prompt ist damit kein Nebenschritt, sondern Teil der inhaltlichen Arbeit. Den Unterschied zwischen geplanter und bloß erzeugter Inhaltsproduktion beschreibt der Artikel zu Content Engineering und Content Generation.
Reasoning-Modelle planen Lösungswege selbst
Reasoning-Modelle planen ihren Lösungsweg selbst, bevor sie antworten. Diese Modelle erzeugen vor der eigentlichen Antwort interne Denkschritte, prüfen Zwischenergebnisse und verwerfen Ansätze. Für Prompts heißt das: Ziel, Rahmen und Erfolgskriterien zählen mehr als vorgegebene Denkschritte.
OpenAI rät bei seinen Reasoning-Modellen ausdrücklich davon ab, sie per Prompt Schritt für Schritt denken zu lassen. Die Modelle tun das bereits intern. Eine zusätzliche Anweisung verbessert das Ergebnis nicht und kann es sogar verschlechtern.
Einfache, direkte Prompts funktionieren bei diesen Modellen am besten. Wie Schlussfolgern und Faktenbasis in KI-Systemen zusammenspielen, erklärt der Artikel zu Grounding und Reasoning.
Gute Prompts verbinden fünf Bausteine
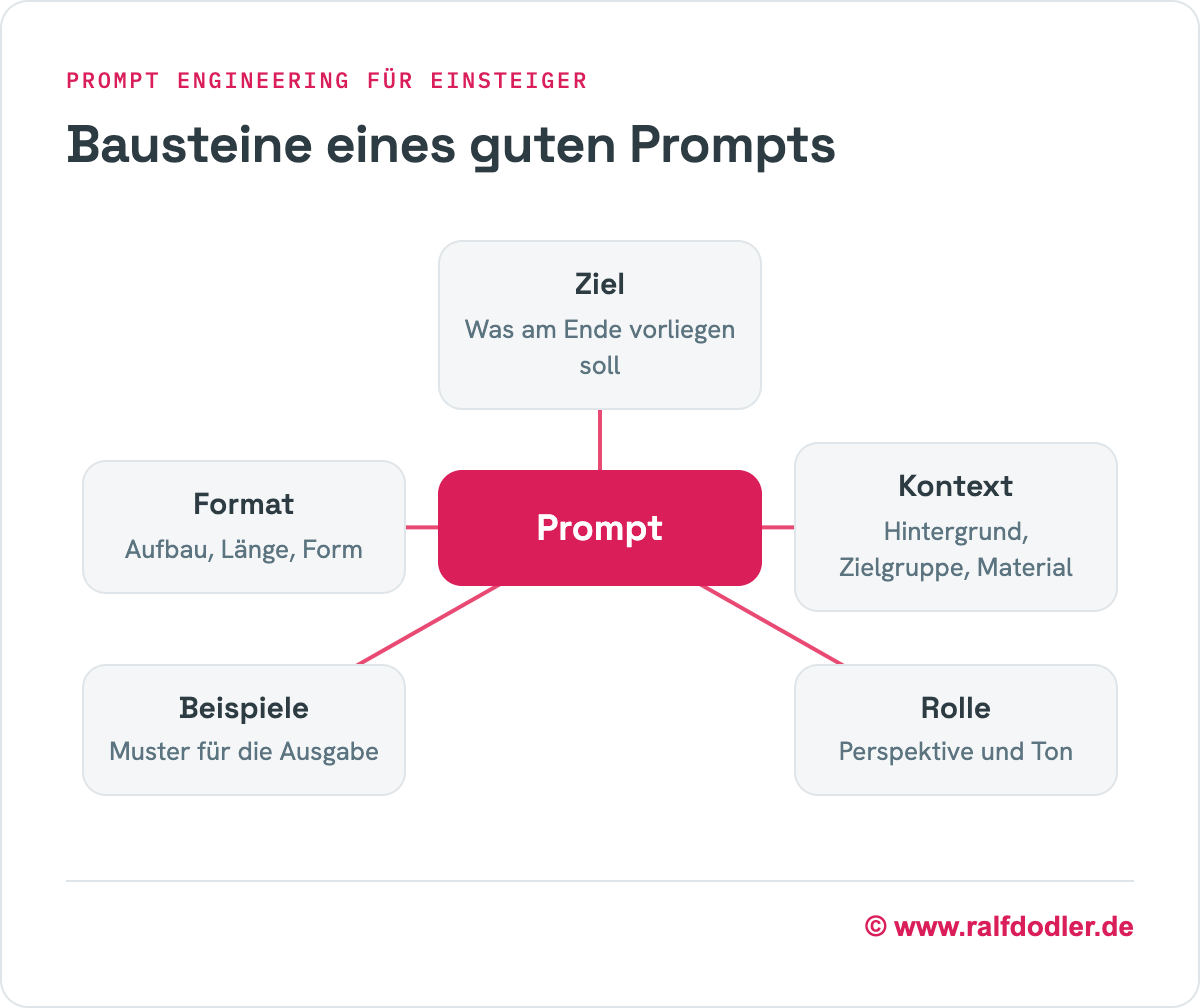
Ein guter Prompt beantwortet fünf Fragen: Was soll entstehen, mit welchem Hintergrund, aus welcher Perspektive, nach welchem Muster und in welcher Form? Nicht jeder Prompt braucht alle fünf Bausteine. Je wichtiger das Ergebnis ist, desto mehr davon gehören hinein.
Ziele bestimmen Ergebnisse
Das Ziel bestimmt, woran ein Sprachmodell seine Antwort ausrichtet. Ein Prompt nennt deshalb zuerst, was am Ende vorliegen soll: ein Blogartikel, eine Entscheidungsvorlage, zehn Ideen oder eine Fehleranalyse.
Zum Ziel gehören Erfolgskriterien. „Ein Artikel für Einsteiger, der ohne Fachbegriffe auskommt und mit einer Handlungsempfehlung endet“ sagt dem Modell, woran es seine Antwort messen soll. Ohne solche Kriterien optimiert das Modell auf Plausibilität, nicht auf deinen Zweck.
Ein klares Ziel macht den Prompt außerdem prüfbar. Wer vorher festlegt, was ein gutes Ergebnis ausmacht, erkennt nach der Antwort sofort, ob der Prompt funktioniert hat oder nachgeschärft werden muss.
Kontext liefert Hintergrundwissen
Kontext gibt dem Sprachmodell das Wissen, das es für deine Aufgabe braucht und nicht von selbst hat. Dazu gehören Zielgruppe, Anlass, Vorwissen der Leser, Material wie Notizen oder Dokumente und die Gründe für Vorgaben.
Die Begründung einer Vorgabe ist besonders wertvoll. „Keine Fachbegriffe, weil die Leser aus dem Vertrieb kommen“ hilft dem Modell, auch in Fällen richtig zu entscheiden, die der Prompt nicht ausdrücklich regelt.
Auch Bildgeneratoren wie Midjourney brauchen Kontext. Dort gehören Stimmung, Licht und Atmosphäre zur Beschreibung, nicht nur das Motiv. Wie sich Kontext mit Grenzen, Beispielen und Verfeinerungen zu einem vollständigen Prompt verbindet, zeigt das CLEAR Framework.
Rollen prägen Tonfall
Eine Rolle prägt Ton, Perspektive und Fachsprache einer Antwort, aber nicht ihre Faktengenauigkeit. Die Anweisung „Du bist ein erfahrener Content-Stratege“ lenkt Wortwahl und Blickwinkel in eine Richtung. Mehr Wissen erzeugt sie nicht.
Das zeigt die Forschung deutlich. Eine Studie mit 162 Rollen und 2.410 Faktenfragen fand durch Rollen im Systemprompt keinen Gesamtgewinn bei der Genauigkeit. Ein Wharton-Report vom Dezember 2025 kam für Expertenrollen zum selben Ergebnis, Laienrollen senkten die Genauigkeit sogar.
Rollen bleiben trotzdem nützlich. Für Stil, Ansprache der Zielgruppe und Perspektive sind sie ein schneller Hebel. Für korrekte Fakten zählen Kontext und Quellen.
Beispiele zeigen Muster
Beispiele zeigen dem Sprachmodell das gewünschte Ergebnis direkter als jede Beschreibung. Diese Technik heißt Few-Shot Prompting: Du gibst mehrere Muster vor, und das Modell übernimmt Aufbau, Länge und Ton. Ohne Beispiel arbeitet das Modell beim Zero-Shot Prompting nur mit der Anweisung.
Die Hersteller bewerten Beispiele unterschiedlich. Anthropic empfiehlt drei bis fünf Beispiele, die vielfältig sind und Randfälle abdecken. Für Reasoning-Modelle rät OpenAI, zuerst ohne Beispiele zu starten und sie nur bei komplexen Anforderungen zu ergänzen.
Beispiel und Anweisung müssen zusammenpassen. Widersprechen sie sich, muss das Modell raten, welche Vorgabe gilt. Wann mehrere Beispiele den Unterschied machen, erklärt der Artikel zu Few-Shot Prompting.
Formatvorgaben strukturieren Antworten
Formatvorgaben legen fest, in welcher Form das Ergebnis ankommt. Ohne sie wählt das Sprachmodell selbst zwischen Fließtext, Liste und Tabelle, und die Form wechselt von Antwort zu Antwort.
Ein Beispiel: „Gib mir zehn Ideen für LinkedIn-Posts“ liefert eine uneinheitliche Aufzählung. „Erstelle eine Tabelle mit den Spalten Thema, Einstiegssatz und Zielgruppe, zehn Zeilen“ liefert ein Ergebnis, das sich direkt weiterverwenden lässt.
Zum Format gehören auch Länge, Gliederung, Sprache und Ausgabeform wie Markdown. Bei längeren Prompts trennen klare Abschnitte mit Überschriften oder Tags Anweisung, Material und Beispiel voneinander. Wie die fünf Bausteine zusammenwirken, zeigt der Vergleich zweier Prompts für denselben Blogartikel.
| Baustein | Schwacher Prompt | Starker Prompt |
|---|---|---|
| Ziel | Schreibe einen Blogartikel über KI-Tools. | Schreibe einen Blogartikel, der Einsteigern hilft, ihr erstes KI-Tool für Texte auszuwählen. |
| Kontext | fehlt | Die Leser sind Content Creator ohne technisches Vorwissen und mit wenig Zeit. |
| Rolle | fehlt | Schreibe aus Sicht einer erfahrenen Redaktion, sachlich und zugewandt. |
| Beispiele | fehlt | Orientiere dich im Einstieg an diesem Absatz: … |
| Format | fehlt | Rund 800 Wörter, drei Zwischenüberschriften, am Ende eine Checkliste. |
Prompting-Techniken lösen unterschiedliche Aufgaben
Prompting-Techniken sind bewährte Muster für typische Aufgaben. Sie unterscheiden sich darin, wie viele Beispiele sie mitgeben und ob sie Denkschritte anfordern. Zu jeder Technik gibt es einen eigenen Artikel, etwa zu One-Shot Prompting, Tree-of-Thought Prompting und Reverse Prompting.
| Technik | Prinzip | Geeignet für |
|---|---|---|
| Zero-Shot | nur Anweisung, kein Beispiel | einfache, klar beschriebene Aufgaben |
| One-Shot | ein Beispiel als Muster | feste Formate und Vorlagen |
| Few-Shot | mehrere Beispiele | wiederkehrende Aufgaben mit Varianten |
| Chain of Thought | Zwischenschritte anfordern | mehrstufige Aufgaben bei Standardmodellen |
| Tree of Thought | mehrere Lösungswege vergleichen | Entscheidungen mit Alternativen |
| Reverse Prompting | Prompt aus einer Ausgabe ableiten | Vorlagen aus guten Ergebnissen |
Chain of Thought verliert Gewicht
Chain of Thought verliert an Bedeutung, weil aktuelle Modelle ohnehin schrittweise denken. Die Technik fordert ein Sprachmodell auf, Zwischenschritte auszuschreiben, bevor es antwortet. 2022 war der Effekt groß: Der Zusatz „Let’s think step by step“ hob die Trefferquote im Rechen-Benchmark MultiArith von 17,7 auf 78,7 Prozent.
Heute sieht das anders aus. Ein Wharton-Report vom Juni 2025 fand bei Modellen ohne Reasoning nur noch kleine Gewinne, dafür schwankendere Antworten. Bei Reasoning-Modellen brachte die Anweisung kaum oder keine Verbesserung, kostete aber deutlich mehr Zeit und Tokens.
Chain of Thought bleibt sinnvoll, wenn du den Lösungsweg sehen und prüfen willst. Wie die Technik im Detail funktioniert, erklärt der Artikel zu Chain-of-Thought Prompting.
Prompt-Ketten zerlegen Aufgaben
Prompt-Ketten zerlegen eine große Aufgabe in mehrere Prompts, die nacheinander laufen. Statt einen Artikel in einem Schritt zu verlangen, lässt du zuerst eine Gliederung erstellen, prüfst sie und lässt dann Abschnitt für Abschnitt schreiben.
Der Vorteil liegt in der Kontrolle. Jedes Zwischenergebnis lässt sich prüfen und korrigieren, bevor es in den nächsten Schritt eingeht. Fehler pflanzen sich so nicht durch das ganze Ergebnis fort.
Diese Technik heißt Prompt Chaining. Sie eignet sich für Aufgaben mit klaren Phasen wie Recherche, Gliederung, Text und Überarbeitung. Für kurze Aufgaben ist ein einzelner, gut gebauter Prompt schneller.
Prompts entstehen iterativ
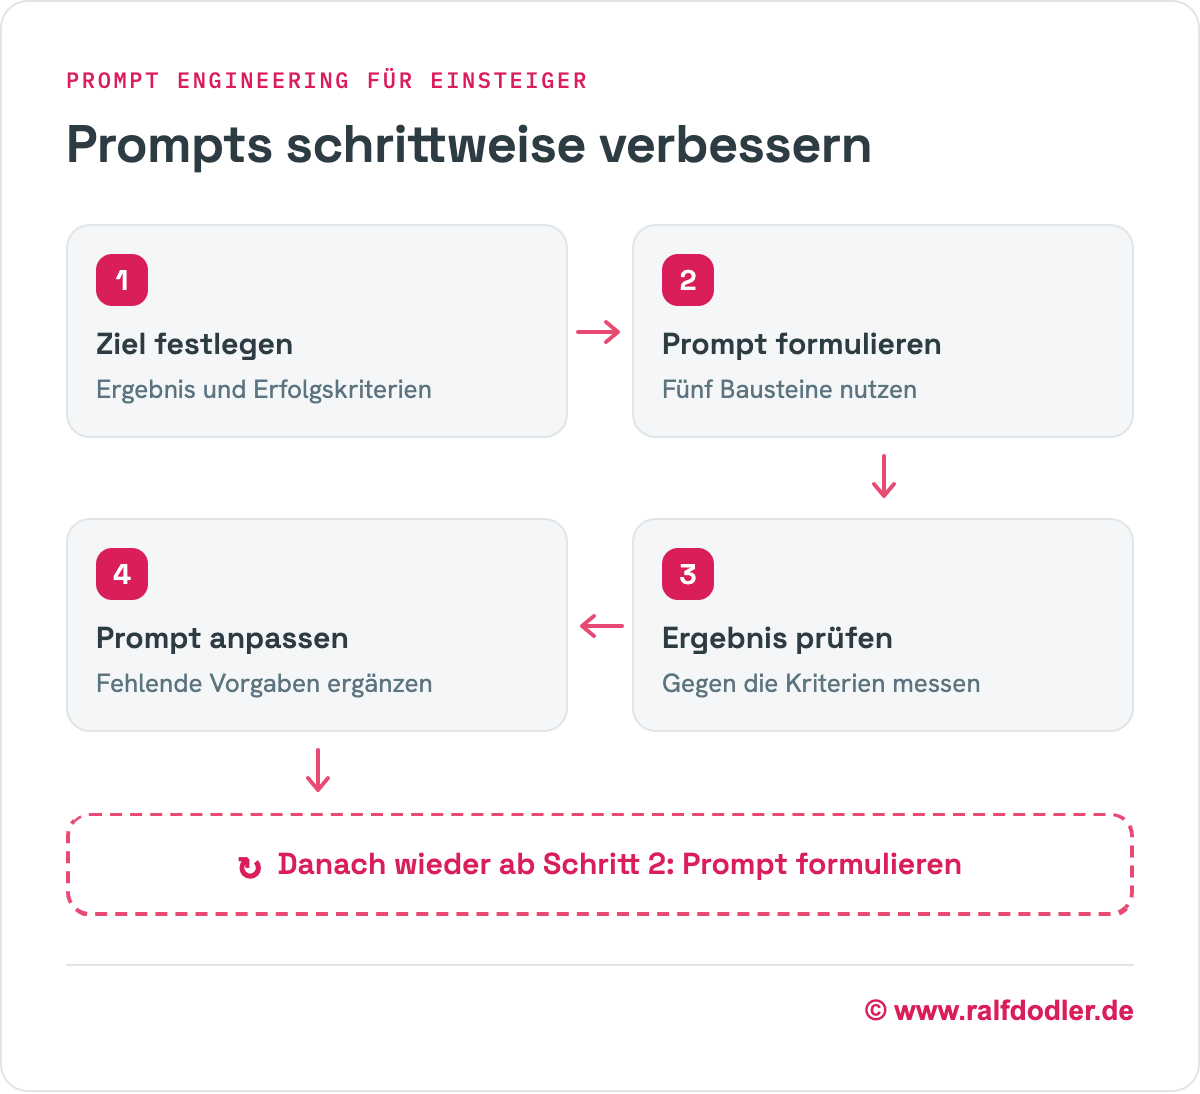
Ein Prompt gelingt selten im ersten Versuch. Gute Prompts entstehen in einem Kreislauf aus Formulieren, Prüfen und Anpassen, bis das Ergebnis die vorher festgelegten Kriterien erfüllt.
Erfolgskriterien machen Prompts prüfbar
Erfolgskriterien machen aus einem Bauchgefühl eine Prüfung. Bevor du einen Prompt schreibst, legst du fest, woran ein gutes Ergebnis erkennbar ist: Länge, Zielgruppe, Pflichtinhalte, Ton und verbotene Formulierungen.
Ohne Kriterien bleibt die Bewertung vage. „Gefällt mir nicht“ sagt nicht, was am Prompt fehlt. „Der Text nennt keine Handlungsempfehlung“ zeigt dagegen genau, welche Vorgabe du ergänzen musst.
Kriterien machen außerdem Versionen vergleichbar. Zwei Varianten eines Prompts lassen sich nur dann fair bewerten, wenn beide an denselben Maßstäben gemessen werden.
Testfälle decken Schwächen auf
Testfälle zeigen, ob ein Prompt nur einmal funktioniert oder zuverlässig. Ein Prompt, der für ein Thema einen guten Text liefert, scheitert womöglich bei einem anderen. Deshalb prüfst du ihn mit mehreren unterschiedlichen Eingaben, auch mit ungewöhnlichen.
Typische Schwächen zeigen sich erst im Vergleich: Der Ton kippt bei kurzen Eingaben, das Format bricht bei langen, Fakten fehlen bei Nischenthemen. Jede Schwäche weist auf eine Vorgabe hin, die im Prompt fehlt.
Bei Fakten reicht der Test des Prompts allein nicht. Ein Sprachmodell macht auch mit gutem Prompt falsche Angaben. Zahlen, Namen und Daten prüfst du deshalb gegen Quellen.
Prompt-Vorlagen sichern Qualität
Prompt-Vorlagen halten bewährte Prompts fest, damit gute Ergebnisse wiederholbar werden. Ein Prompt, der nach mehreren Runden funktioniert, wird als Vorlage mit Platzhaltern gespeichert, etwa für Thema, Zielgruppe und Länge.
Vorlagen sparen Zeit und machen Ergebnisse im Team vergleichbar. Alle nutzen dieselben Bausteine und dieselben Kriterien, statt den Prompt jedes Mal neu zu erfinden.
Wer Vorlagen systematisch aufbaut, betreibt Instruction Design für stabile KI-Anweisungen. Wie du aus einem guten Ergebnis rückwärts die passende Vorlage ableitest, zeigt der Ansatz des Reverse Prompting.
Context Engineering erweitert Prompt Engineering
Oft heißt es, Prompt Engineering werde überflüssig, weil KI-Agenten Aufgaben selbst zerlegen. Tatsächlich wird der Prompt Teil eines größeren Ganzen. Context Engineering beschreibt dieses Ganze.
Agenten brauchen kuratierten Kontext
Agenten brauchen einen sorgfältig ausgewählten Kontext, weil sie über viele Schritte arbeiten. Ein KI-Agent liest Dokumente, ruft Werkzeuge auf, sammelt Zwischenergebnisse und führt einen Verlauf. All das landet im begrenzten Kontextfenster des Sprachmodells.
Anthropic definiert Context Engineering als die Strategien, mit denen genau die passenden Informationen während der Verarbeitung ins Kontextfenster gelangen und dort gepflegt werden. Prompt Engineering ist darin die Schicht der Anweisungen. Context Engineering kümmert sich zusätzlich um alles andere, was das Modell sieht.
Wie Agenten Wissen selbst abrufen und bewerten, beschreibt der Artikel zu Agentic RAG.
| Bestandteil | Inhalt | Wer liefert ihn |
|---|---|---|
| Systemprompt | Rolle, Regeln, Ziel | Entwickler oder Nutzer |
| Nutzerprompt | konkrete Aufgabe | Nutzer |
| Dokumente | Wissen zur Aufgabe | Nutzer oder Abruf aus einem Index |
| Werkzeugergebnisse | Suchtreffer, Daten, Berechnungen | Agent |
| Verlauf | bisherige Schritte und Antworten | System |
Anweisungen bleiben Kernkompetenz
Klare Anweisungen bleiben die Kernkompetenz, auch wenn Agenten viele Prompts selbst schreiben. Ein Agent zerlegt eine Aufgabe in Teilschritte, aber Ziel, Kriterien und Grenzen kommen von dir.
Ist das Ziel unklar, arbeitet auch der beste Agent in die falsche Richtung, nur schneller und über mehr Schritte. Die Fähigkeit, eine Absicht in eine präzise Anweisung zu übersetzen, verlagert sich deshalb nur: vom einzelnen Prompt im Chat zur Aufgabenbeschreibung für ein System.
Prompt Engineering wird so zur Grundkompetenz für alle, die mit KI arbeiten. Die Begriffe ändern sich, die Aufgabe bleibt: wissen, was du willst, und es so formulieren, dass eine Maschine es umsetzen kann.
Prompts verändern Suchanfragen
Prompts sind nicht nur Arbeitsanweisungen, sondern auch die neue Form der Suchanfrage. Wer ChatGPT, Perplexity oder den AI Mode von Google fragt, formuliert einen Prompt. Das Generative Authority Model von Ralf Dodler beschreibt, wie Inhalte zu zitierfähigen Quellen solcher Antworten werden.
Prompts sind länger als Keywords
Prompts sind deutlich länger als klassische Suchanfragen. Eine Semrush-Auswertung von fast 69 Millionen Suchsitzungen aus Mai bis Juli 2025 ergab für Anfragen im AI Mode von Google im Schnitt 7,22 Wörter. Klassische Google-Suchanfragen kamen auf 4,0 Wörter.
Längere Anfragen enthalten mehr Kontext. Nutzer nennen ihre Situation, ihr Ziel und ihre Einschränkungen, also genau die Bausteine eines guten Prompts. Aus „CRM Software“ wird „Welches CRM eignet sich für ein Team von fünf Leuten ohne IT-Abteilung?“.
Ein Text konkurriert damit nicht mehr nur um ein Keyword, sondern um die Antwort auf eine konkrete Situation. Inhalte, die solche Situationen ausdrücklich behandeln, passen besser zu langen Prompts.
Query Fan-out zerlegt Fragen
Query Fan-out zerlegt eine Frage in viele Teilanfragen, die ein KI-System parallel stellt. Google beschreibt für den AI Mode, dass das System eine Frage in Unterthemen aufteilt und eine Vielzahl von Suchanfragen gleichzeitig ausführt. Die Antwort setzt sich aus den Treffern dieser Teilanfragen zusammen.
Der Mechanismus ähnelt einer Prompt-Kette. Das System macht aus einer komplexen Frage mehrere einfache Fragen und bearbeitet sie einzeln.
Für Inhalte zählt deshalb nicht nur die Hauptfrage. Ein Text wird auch über Teilaspekte gefunden, die der Nutzer nie selbst eingegeben hat. Wie das Verfahren abläuft, erklärt der Artikel zu Query Fan-out.
Inhalte beantworten zerlegte Fragen
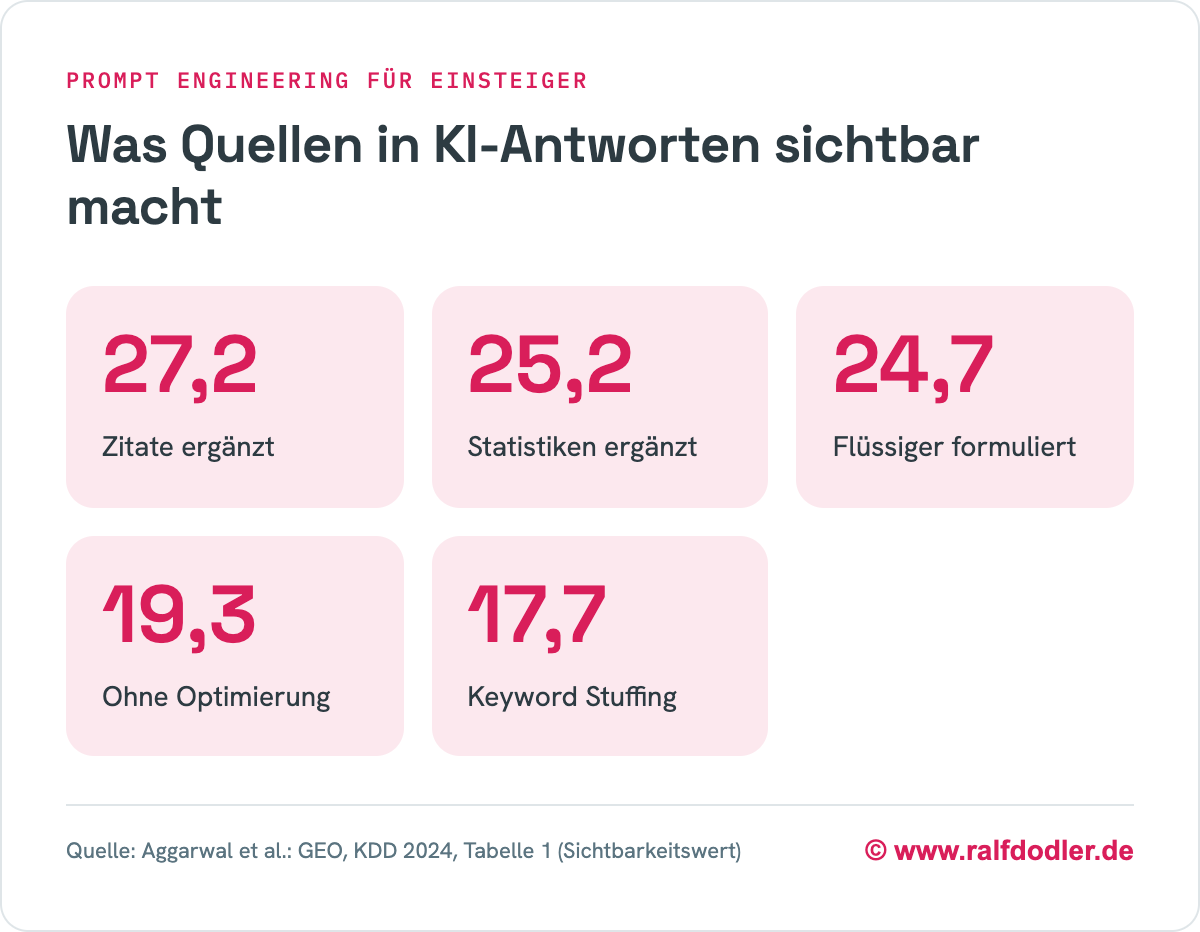
Inhalte werden in KI-Antworten sichtbarer, wenn sie Teilfragen klar beantworten und mit Zitaten und Zahlen belegen. Die GEO-Studie von Forschern der Princeton University und weiterer Einrichtungen hat das 2024 an generativen Suchsystemen gemessen. Ohne Optimierung erreichten Quellen einen Sichtbarkeitswert von 19,3. Ergänzte Zitate hoben ihn auf 27,2, ergänzte Statistiken auf 25,2 und flüssigere Formulierungen auf 24,7. Keyword Stuffing senkte ihn auf 17,7.
Der Wert misst, wie viel Text einer Quelle in der Antwort landet und wie weit oben. Klicks misst er nicht.
Die Verbindung zum Prompt Engineering liegt in der Perspektive. Wer versteht, wie Nutzer heute fragen, weiß, welche Fragen ein Inhalt beantworten muss. Diesen Ansatz verfolgt die Generative Engine Optimization.
Verwandte Themen
Prompt Engineering ist der Einstieg in ein Feld, das von einzelnen Prompting-Techniken bis zu Anweisungssystemen für KI-Agenten reicht. Die folgenden Themen vertiefen einzelne Techniken oder führen zu angrenzenden Konzepten wie Grounding und Context Engineering.
Wichtige verwandte Themen sind:
- Instruction Design
- CLEAR Framework
- Few-Shot Prompting
- Chain-of-Thought Prompting
- Reverse Prompting
- Grounding in der KI
- Context Engineering
- Prompt Chaining
FAQ zu Prompt Engineering
Braucht Prompt Engineering Programmierkenntnisse?
Prompt Engineering braucht keine Programmierkenntnisse, weil Prompts in natürlicher Sprache formuliert werden. Entscheidend sind ein klares Ziel, Wissen über die Aufgabe und sprachliche Präzision. Programmierkenntnisse werden erst relevant, wenn Prompts über eine Schnittstelle in eigene Anwendungen eingebunden werden.
Wie lang ist ein guter Prompt?
Die Länge eines guten Prompts richtet sich nach der Information, die das Sprachmodell für die Aufgabe braucht. Einfache Aufgaben kommen mit einem Satz aus, komplexe Aufgaben brauchen Kontext, Material und Formatvorgaben über mehrere Absätze. Überflüssige Angaben verwässern den Prompt, weil das Sprachmodell jede Angabe als relevant behandelt.
Funktioniert ein Prompt in jedem KI-Modell gleich?
Ein Prompt liefert in verschiedenen KI-Modellen unterschiedliche Ergebnisse, weil jedes Modell mit eigenen Daten und Verfahren trainiert wurde. Die Modelle gewichten Anweisungen, Beispiele und Formatvorgaben verschieden. Ein Prompt braucht beim Wechsel auf ein anderes Modell deshalb einen neuen Test mit denselben Erfolgskriterien.
Was ist ein Systemprompt?
Ein Systemprompt ist eine Anweisung, die vor dem eigentlichen Gespräch steht und für alle folgenden Nutzerprompts gilt. Der Systemprompt legt Rolle, Regeln, Tonalität und Grenzen fest, bevor der Nutzer seine erste Frage stellt. In KI-Tools steckt der Systemprompt hinter Funktionen wie benutzerdefinierten Anweisungen, in KI-Anwendungen setzt ihn der Entwickler.
Welche Daten gehören nicht in einen Prompt?
Vertrauliche Unternehmensdaten, personenbezogene Daten und Zugangsdaten gehören nicht in Prompts an öffentliche KI-Tools. Ein Prompt verlässt das eigene System und landet beim Anbieter, der Eingaben speichert und abhängig von den Einstellungen für das Training verwendet. Sensible Inhalte verarbeiten Unternehmen deshalb nur mit Lösungen, die das Training vertraglich ausschließen, oder mit anonymisierten Daten.
Zentrale Erkenntnisse von Ralf Dodler zu Prompt Engineering
„Wer der KI nicht sagen kann, woran ein gutes Ergebnis zu erkennen ist, bekommt ein durchschnittliches, und daran ändern auch Reasoning-Modelle und Agenten nichts.“
– Ralf Dodler, Generative SEO-Stratege
- Prompt Engineering übersetzt ein Ziel in Kontext, Vorgaben und Beispiele, die ein Sprachmodell eindeutig auswerten kann.
- Sprachmodelle füllen fehlende Angaben mit der wahrscheinlichsten Fortsetzung und liefern bei vagen Prompts Durchschnittstexte.
- Ein guter Prompt verbindet die fünf Bausteine Ziel, Kontext, Rolle, Beispiele und Format.
- Rollen steuern Ton und Perspektive einer Antwort, verbessern aber nicht ihre Faktengenauigkeit.
- Reasoning-Modelle denken selbst schrittweise, deshalb zählen bei ihnen Ziel und Erfolgskriterien mehr als vorgegebene Denkschritte.
- Gute Prompts entstehen iterativ aus Formulieren, Prüfen gegen feste Kriterien und Anpassen.
- Context Engineering erweitert Prompt Engineering um alles, was ein Sprachmodell beim Antworten sieht.
- Prompts in AI-Search sind länger als Keywords, deshalb müssen Inhalte konkrete Situationen und Teilfragen beantworten.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).