Semantische Optimierung: Wie Phrasen Inhalte für Suche und KI verständlich machen
Viele Texte nennen ihr Keyword zehnmal und bleiben trotzdem unscharf. Leser und Suchsysteme erkennen zwar das Thema, aber nicht, wie es gemeint ist und wem der Text helfen soll.
Semantische Optimierung setzt an dieser Lücke an. Sie richtet Texte an Phrasen, Entitäten und Begriffszusammenhängen aus statt an der Häufigkeit einzelner Wörter. Das wird wichtiger, weil semantische Suche und AI-Search Inhalte nach Bedeutung abrufen und einzelne Passagen bewerten.
Semantische Optimierung gehört zur semantischen SEO und damit zum Feld des Information Retrieval, das untersucht, wie Suchsysteme Texte verstehen, gewichten und abrufen.
In diesem Artikel erfährst du, wie semantische Optimierung funktioniert, wie Suchsysteme Phrasenmuster erkennen und wie du eigene Texte Schritt für Schritt prüfst.
Was ist semantische Optimierung?
Semantische Optimierung ist die Überarbeitung von Inhalten nach Bedeutungszusammenhängen, also nach typischen Phrasen, Entitäten und Begriffsnachbarschaften eines Themas. Semantische Optimierung nutzt dafür das Wissen, wie Suchsysteme Sprache über Verfahren wie N-Gramme, Co-Occurrence und Embeddings auswerten.
Die klassische Keyword-Optimierung fragt, ob und wie oft ein Begriff im Text steht. Semantische Optimierung fragt, ob der Text das Thema so beschreibt, wie Fachleute und Suchende darüber sprechen. Der Maßstab verschiebt sich vom einzelnen Wort zur Bedeutungseinheit.
Damit ist semantische Optimierung die Textebene der semantischen SEO. Semantische SEO plant Themen, Entitäten und Seitenarchitektur. Semantische Optimierung setzt diese Planung im einzelnen Absatz um und macht Inhalte für die semantische Suche lesbar.
| Merkmal | Keyword-Optimierung | Semantische Optimierung |
|---|---|---|
| Einheit | Einzelnes Keyword | Phrase, Entität, Begriffsfeld |
| Ziel | Begriff sichtbar platzieren | Thema vollständig und eindeutig beschreiben |
| Prüffrage | Steht das Keyword oft genug im Text? | Klingt der Text wie von jemandem, der das Thema kennt? |
| Messgröße | Keyword-Dichte, Position | Abdeckung typischer Phrasen und Teilthemen |
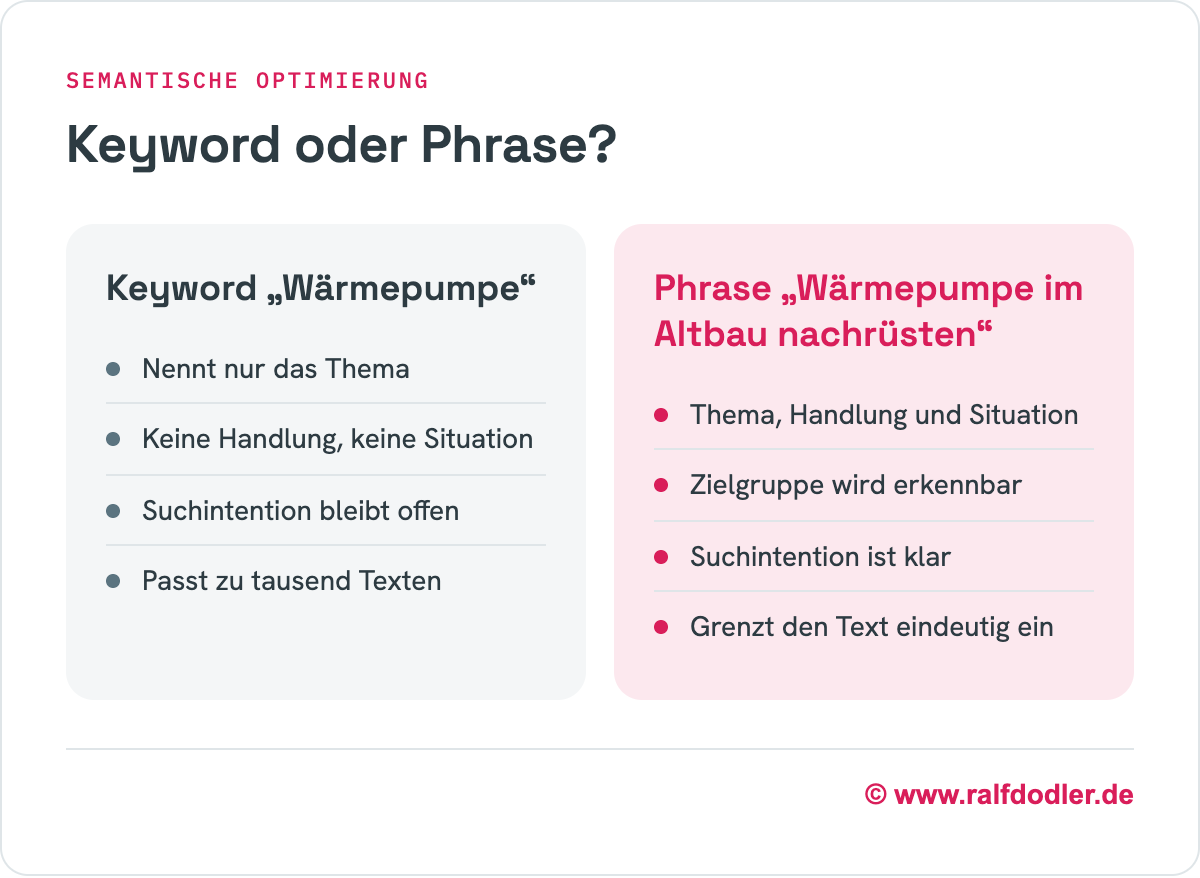
| Beispiel | „Wärmepumpe“ | „Wärmepumpe im Altbau nachrüsten“ |
| Risiko | Keyword-Stuffing, hölzerne Sätze | Phrasenhäufung ohne Aussage |
Phrasen tragen Bedeutung
Ein Keyword benennt ein Thema, eine Phrase zeigt, wie das Thema gemeint ist. Die folgenden Abschnitte zeigen den Unterschied und erklären, warum Phrasen aus Suchintentionen entstehen.
Keywords benennen nur Themen
Ein Keyword wirkt wie ein Etikett. Begriffe wie „CRM“, „Content-Marketing“ oder „Wärmepumpe“ sagen, worüber ein Text spricht. Sie sagen nicht, aus welcher Perspektive, für wen und mit welchem Ziel.
Viele Inhalte entstehen trotzdem noch aus Keyword-Listen. Der Begriff soll möglichst oft und möglichst weit oben stehen. Das Ergebnis sind Texte, die das Thema nennen, aber nicht erschließen.
Ein Keyword holt Leser ins Thema. Erst die Einbettung in Zusammenhänge zeigt ihnen, dass der Text das Thema verstanden hat. Diese Einbettung leisten Phrasen.
Phrasen verbinden Begriffe
Eine Phrase verbindet mehrere Begriffe zu einer Bedeutungseinheit. „CRM-System für kleine Unternehmen“ nennt das Thema, die Zielgruppe und indirekt den Bedarf. „Nachhaltige Verpackung für den E-Commerce“ grenzt einen großen Begriff auf einen konkreten Anwendungsfall ein.
Phrasen geben einem Text damit Richtung. Sie zeigen, welche Aspekte eines Themas der Text behandelt und welche nicht. Für Leser entsteht Orientierung, für Suchsysteme entsteht Kontext.
Semantische Optimierung fragt deshalb nicht nur, was im Text steht. Semantische Optimierung fragt, wie die Begriffe zueinander stehen und ob ihre Verbindungen dem Thema entsprechen.
Suchintentionen erzeugen Sprachmuster
Typische Phrasen entstehen nicht zufällig. Sie entstehen aus der Suchintention (Search Intent), also aus der Nutzerintention hinter einer Anfrage: Menschen wollen etwas wissen oder erreichen. Wer sich über E-Mail-Automatisierung informiert, sucht selten nur nach „E-Mail“.
Suchende formulieren stattdessen „E-Mails automatisiert versenden“, „Follow-up-E-Mail nach dem Kauf“ oder „Willkommensmail für neue Kunden“. Jede dieser Phrasen beschreibt eine Absicht. Gute Texte zum Thema greifen dieselben Formulierungen auf, weil sie dieselben Fragen beantworten.
Suchsysteme werten solche Formulierungen schon bei der Anfrage aus. Das Query Understanding erkennt Phrasen in der Suchanfrage und leitet daraus die Intention ab. Ein Text, der dieselben Sprachmuster nutzt, passt besser zu dieser Intention.
Suchsysteme erkennen Phrasenmuster
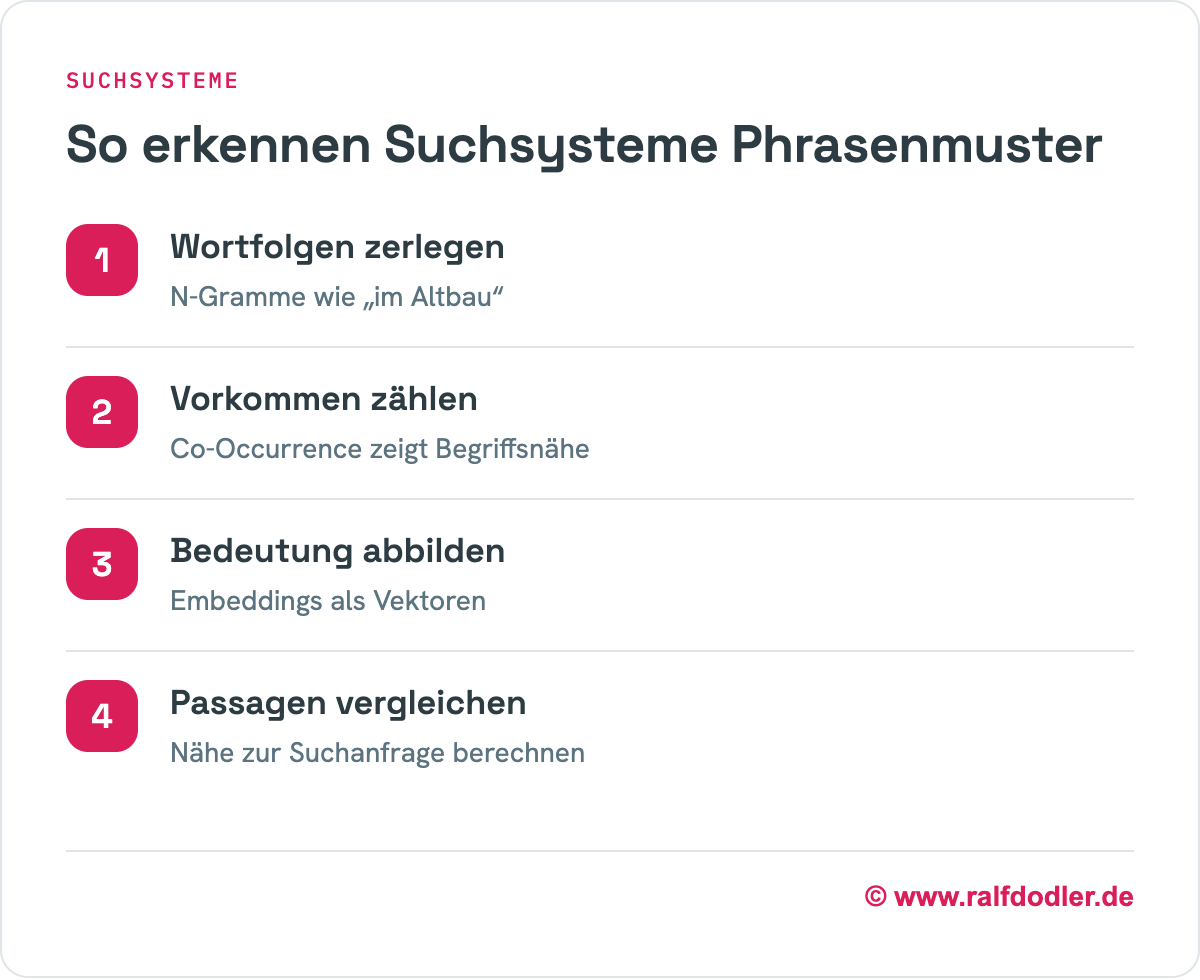
Suchsysteme verstehen Sprache nicht wie Menschen. Sie erkennen Muster über Häufigkeit, Nachbarschaft und gemeinsames Vorkommen. Vier Verfahren zeigen, wie aus diesen Mustern ein Signal für Bedeutung wird.
N-Gramme machen Phrasen zählbar
Ein N-Gramm ist eine Folge von n Wörtern aus einem Text. N-Gramme zerlegen Sätze in überlappende Wortfolgen wie „Wärmepumpe im“ und „im Altbau“. So werden Phrasen für ein System zählbar.
Aus den Zählungen vieler Texte entsteht ein Bild davon, welche Wortfolgen zu einem Thema gehören. Die häufigsten Bigramme und Trigramme eines Themas decken sich weitgehend mit den Phrasen, die Fachleute verwenden.
Verfahren wie TF-IDF gewichten diese Begriffe zusätzlich. TF-IDF hebt Begriffe hervor, die in einem Dokument häufig und im gesamten Bestand selten sind. Solche Begriffe kennzeichnen ein Dokument besonders gut.
Co-Occurrence zeigt Begriffsnähe
Co-Occurrence misst, welche Begriffe gemeinsam in einem Satz, Absatz oder Dokument auftreten. Anders als ein N-Gramm braucht Co-Occurrence keine feste Reihenfolge. Es genügt, dass zwei Begriffe regelmäßig nahe beieinanderstehen.
Treten „Wärmepumpe“, „Altbau“ und „Vorlauftemperatur“ immer wieder gemeinsam auf, lernt ein System ihre Verwandtschaft. Ein Text über Wärmepumpen im Altbau ohne den Begriff „Vorlauftemperatur“ wirkt dann unvollständig.
Für semantische Optimierung heißt das: Ein Thema hat ein erwartbares Begriffsumfeld, ein semantisches Feld. Texte, die dieses Umfeld abdecken, erscheinen für Suchsysteme thematisch geschlossen.
Embeddings bilden Bedeutung ab
Embeddings übersetzen Wörter, Sätze oder Passagen in Zahlenvektoren. Sprachmodelle lernen diese Vektoren aus großen Textmengen, letztlich aus denselben Mustern des gemeinsamen Vorkommens. Ähnliche Bedeutungen liegen im Vektorraum nah beieinander.
Embeddings erkennen deshalb auch Synonyme und Umschreibungen. „Heizung modernisieren“ und „Heizsystem erneuern“ liegen nah beieinander, obwohl sie kein Wort teilen. Über Vector Retrieval finden Suchsysteme so Passagen, die zur Anfrage passen, ohne sie wörtlich zu wiederholen.
Für Texte heißt das: Wörtliche Wiederholung ist nicht nötig. Entscheidend ist, dass eine Passage die Bedeutung der Anfrage klar trägt.
Entitäten verankern Phrasen
Eine Entität ist ein eindeutig bestimmbares Ding, etwa eine Person, ein Produkt, ein Ort oder ein Konzept. Suchsysteme erkennen Entitäten im Text und verknüpfen sie mit ihrem Wissen über die Welt. Entity SEO baut auf diesem Prinzip auf.
Phrasen gewinnen Eindeutigkeit, wenn sie an Entitäten hängen. „Förderung für Wärmepumpen“ bleibt vage, „KfW-Förderung für Wärmepumpen“ nennt eine konkrete Organisation. Die Entität verankert die Phrase in einem bekannten Zusammenhang.
Wie zentral eine Entität für einen Text ist, beschreibt die Entity Salience. Semantische Optimierung sorgt dafür, dass die Hauptentität früh, häufig und in tragenden Sätzen erscheint.
Dasselbe Muster gilt für Gesetze und Produkte. „Heizungsgesetz“ wird zum „Gebäudeenergiegesetz (GEG)“, „Leistungsdaten prüfen“ wird zu „Leistungsdaten in der Google Search Console prüfen“.
| Phrase ohne Entität | Phrase mit Entität | Entitätstyp |
|---|---|---|
| Förderung für Wärmepumpen | KfW-Förderung für Wärmepumpen | Organisation |
| Heizungsgesetz | Gebäudeenergiegesetz (GEG) | Gesetz |
| Leistungsdaten prüfen | Leistungsdaten in der Google Search Console prüfen | Produkt |
AI-Search bevorzugt bedeutungsdichte Passagen
AI-Search-Systeme rufen keine ganzen Seiten ab, sondern einzelne Passagen. Über Passage Retrieval wählen sie die Abschnitte aus, die eine Frage am besten beantworten, und bauen daraus ihre Antwort. Das Generative Authority Model von Ralf Dodler beschreibt die Abrufbarkeit solcher Passagen als Retrieval Activation. Semantische Optimierung macht Passagen abrufbar, indem sie Bedeutung in jedem Abschnitt explizit macht.
Chunks brauchen eigenen Kontext
Vor dem Abruf zerlegen Retrieval-Systeme Dokumente in Abschnitte, sogenannte Chunks. Das Document Chunking trennt Texte an Überschriften, Absätzen oder nach einer festen Länge.
Ein Chunk steht danach für sich. Er verliert die Einleitung, die Überschrift darüber und den Absatz davor. Was im Chunk nicht steht, kennt das System beim Abruf nicht.
Verfahren wie Contextual Retrieval ergänzen deshalb fehlenden Kontext maschinell. Besser ist ein Text, der diesen Kontext selbst liefert. Jeder Abschnitt nennt sein Thema, seine Hauptentität und die Phrase, um die es geht.
Begriffe ersetzen Pronomen
Pronomen machen Texte flüssig, aber sie brechen den Bezug in isolierten Passagen. Ein Satz wie „Sie spart vor allem im Altbau Kosten“ ist ohne den Satz davor wertlos. Das System weiß nicht, wer „sie“ ist.
Semantisch optimierte Texte wiederholen deshalb den Begriff in tragenden Sätzen. „Eine Wärmepumpe spart im Altbau vor allem dann Kosten, wenn die Vorlauftemperatur niedrig bleibt.“ Dieser Satz funktioniert allein und lässt sich direkt zitieren.
Das gilt besonders für Definitionen, Kernaussagen und den ersten Satz nach einer Überschrift. Diese Sätze ziehen AI-Search-Systeme am häufigsten als Antwort heran.
| Merkmal | Schwache Passage | Bedeutungsdichte Passage |
|---|---|---|
| Bezug | Pronomen („sie“, „das“) | Begriff wird wiederholt |
| Begriff | Allgemein („die Anlage“) | Konkret („die Luft-Wasser-Wärmepumpe“) |
| Phrase | Einzelnes Keyword | Typische Phrase des Themas |
| Entität | Fehlt | Benannt (z. B. KfW) |
| Beispielsatz | „Das lohnt sich meist.“ | „Eine Wärmepumpe lohnt sich im Altbau bei niedriger Vorlauftemperatur.“ |
Phrasenrecherche beginnt bei Vergleichstexten
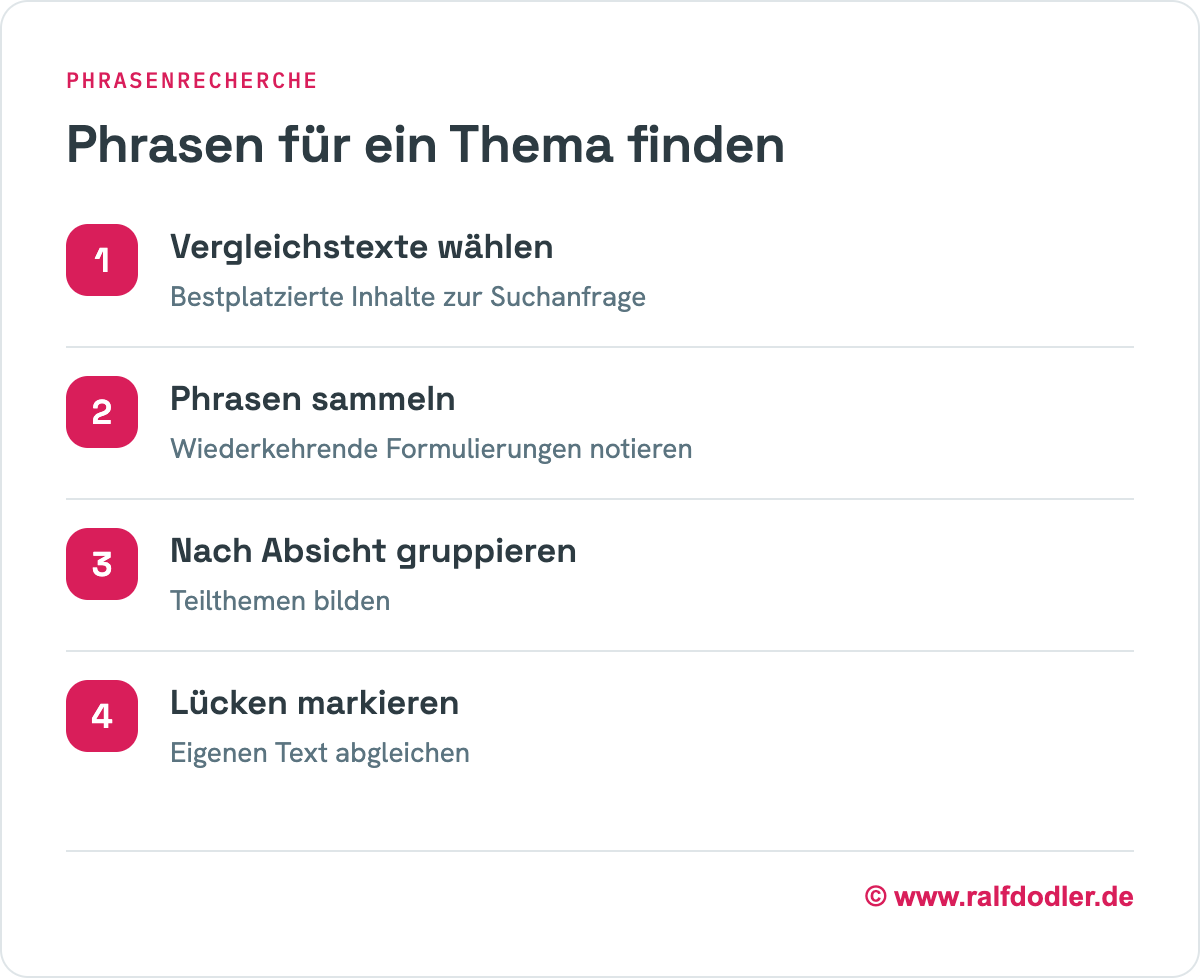
Typische Phrasen lassen sich nicht ausdenken, sie lassen sich beobachten. Die beste Quelle sind Texte, die zum Thema bereits gut funktionieren. Drei Wege führen zu einer belastbaren Phrasenliste.
Top-Inhalte zeigen typische Formulierungen
Die bestplatzierten Inhalte zu einer Suchanfrage zeigen, wie ein Thema sprachlich erschlossen wird. Dabei zählen nicht die Keywords, sondern die Formulierungen: Welche Phrasen kehren in mehreren Texten wieder, und wie betten die Texte zentrale Begriffe ein?
Ein Beispiel ist das Thema Energieeffizienz. Gute Texte nennen nicht nur den Begriff, sondern Phrasen wie „Energieeffizienz im Altbau steigern“, „Förderprogramme für energieeffizientes Sanieren“ oder „Heizkosten durch Dämmung senken“.
Die Stärke dieser Phrasen liegt nicht in ihrer Originalität. Sie verbinden einen Fachbegriff mit Anwendung, Ziel oder Situation und decken so die Teilthemen ab, die Suchende erwarten.
Tools zählen Phrasenhäufigkeit
Content-Tools wie Surfer oder Frase werten Vergleichstexte automatisch aus. Sie zeigen, welche Begriffe und Phrasen in Top-Texten überdurchschnittlich oft vorkommen. Technisch beruhen diese Auswertungen auf N-Gramm-Zählung und Termgewichtung.
Die Ergebnisse sind Hinweise, keine Vorgaben. Eine Liste mit 80 Begriffen verleitet dazu, jeden Begriff irgendwo unterzubringen. So entstehen wieder Keyword-Texte, nur mit mehr Wörtern.
Sinnvoller ist ein Filter: Welche Phrasen beschreiben ein Teilthema, das im eigenen Text fehlt? Welche lassen sich in den eigenen Stil übersetzen? Tools liefern das Rohmaterial, die Auswahl bleibt redaktionelle Arbeit.
Sprachmodelle spiegeln Sprachmuster
Sprachmodelle wie ChatGPT, Gemini oder Claude haben typische Formulierungen aus großen Textmengen gelernt. Dadurch eignen sie sich als Mustererkenner. Sie zeigen, welche Phrasen in einem Text wiederkehren und welche zum Thema fehlen.
Ein einfacher Prompt genügt: „Lies diesen Text und nenne mir fünf Phrasen, die für das Thema Contentstrategie typisch sind, im Text aber fehlen.“ Die Antwort ist ein Spiegel des eigenen Textes.
Das Sprachmodell dient dabei als Prüfinstrument, nicht als Autor. Die Vorschläge zeigen Lücken. Ob eine Phrase in den Text gehört, entscheidet die fachliche Prüfung.
Semantische Optimierung prüft Texte
Semantische Optimierung lässt sich in klare Prüfpunkte übersetzen. Diese Punkte helfen beim Schreiben und bei der Überarbeitung bestehender Inhalte. Texte, die sie erfüllen, sprechen ein Thema konsistent an. Über viele Artikel hinweg stützt diese Konsistenz die Topical Authority einer Website.
Die Tabelle fasst die Prüfpunkte zusammen, die folgenden Abschnitte erklären die wichtigsten.
| Prüfpunkt | Prüffrage | Warnsignal |
|---|---|---|
| Phrasen | Enthält der Text die typischen Phrasen des Themas? | Nur das Hauptkeyword wiederholt sich |
| Teilthemen | Hat jedes erwartete Teilthema einen eigenen Abschnitt? | Phrasen eines Teilthemas fehlen ganz |
| Entitäten | Sind die zentralen Entitäten benannt? | Nur allgemeine Begriffe wie „die Anlage“ |
| Passagen | Versteht man jeden Abschnitt ohne den davor? | Pronomen am Abschnittsanfang |
| Überschriften | Benennt jede Überschrift eine Beziehung? | Reine Themenlabels |
Phrasen decken Teilthemen ab
Jedes Teilthema hat eigene typische Phrasen. Ein vollständiger Text über Remote Work enthält Formulierungen wie „hybrides Arbeiten ermöglichen“, „digitale Zusammenarbeit im Team“ oder „Führung auf Distanz“ enthalten.
Fehlen die Phrasen eines Teilthemas ganz, fehlt auch die inhaltliche Behandlung des Teilthemas. Die Phrasenliste aus der Recherche wird so zur Prüfliste für die Vollständigkeit.
Wichtig ist die Richtung der Prüfung. Eine fehlende Phrase ist ein Hinweis auf eine inhaltliche Lücke. Die Lücke schließt ein erklärender Absatz, nicht die nachträglich eingefügte Phrase.
Cluster gliedern Themenfelder
Verwandte Phrasen bilden Gruppen. In einem Artikel über Shop-Optimierung gehören „Navigation verbessern“ und „Klickpfade verkürzen“ zusammen, ebenso „Ladezeit reduzieren“ und „Bilder komprimieren“.
Jede Gruppe verdient einen eigenen Abschnitt mit eigener Überschrift. So entsteht eine Gliederung, die das Themenfeld abbildet, statt einer losen Aufzählung von Begriffen.
Über einzelne Artikel hinaus helfen Topical Maps, solche Gruppen auf eine ganze Website zu verteilen. Wie aus einer zentralen Entität ein vollständiges Content-Cluster entsteht, zeigt die Planung auf Themenebene.
Varianten ersetzen Wiederholungen
Semantische Optimierung lebt von Varianten, nicht von Wiederholung. Statt fünfmal „Wärmepumpe installieren“ zu schreiben, kann ein Text auch „Heizsystem mit Wärmepumpe modernisieren“ oder „Nachrüstung einer Wärmepumpe im Bestand“ verwenden.
Varianten decken mehr Formulierungen ab, mit denen Menschen suchen. Embeddings erkennen ihre Verwandtschaft ohnehin. Der Text wird dadurch breiter anschlussfähig und liest sich natürlicher.
Die Grenze liegt dort, wo Phrasen keine Aussage mehr tragen. Eine Häufung typischer Formulierungen ohne neuen Inhalt wirkt auf Leser genauso hölzern wie Keyword-Stuffing.
Überschriften benennen Beziehungen
Überschriften sind die stärksten Phrasen eines Textes. Sie gliedern den Inhalt und begrenzen die Chunks, die Suchsysteme abrufen.
Eine gute Überschrift benennt eine Beziehung statt eines Etiketts. „Typische Phrasen geben Orientierung“ sagt mehr als „Sprachliche Beispiele im Content“. Leser und Systeme erkennen sofort, welche Aussage der Abschnitt trägt.
Dasselbe gilt für Sätze. „SEO, Content-Strategie, Keywords und Conversion“ ist eine Aufzählung. „Eine Content-Strategie verbindet SEO-Ziele mit Begriffen, die zur Conversion führen“ ist eine Aussage mit klarer Beziehung.
Verwandte Themen
Semantische Optimierung verbindet Schreibpraxis mit den Verfahren, mit denen Suchsysteme Sprache auswerten. Sie steht neben Ansätzen, die Themen planen, Begriffe zählen oder Passagen abrufen.
Während semantische Optimierung am einzelnen Text arbeitet, beschreiben die verwandten Themen die Mechanik dahinter und die Planung darüber.
Wichtige verwandte Themen sind:
- Semantische SEO
- N-Gramm
- Co-Occurrence
- Entity Salience
- Passage Retrieval
- Topical Authority
- Topical Maps
- N-Gramm-Analyse
FAQ zur semantischen Optimierung
Woran erkennt man den Erfolg semantischer Optimierung?
Semantische Optimierung zeigt Erfolg an der Zahl der Suchanfragen, für die eine Seite sichtbar wird. Ein semantisch vollständiger Text erhält Impressionen für mehr Varianten und Teilfragen eines Themas als ein Text mit einem einzelnen Keyword. In AI-Search zeigt sich der Erfolg daran, dass Passagen der Seite als Quelle in generierten Antworten erscheinen.
Ersetzt semantische Optimierung die WDF*IDF-Analyse?
Semantische Optimierung ersetzt WDFIDF als Zielgröße, nutzt die Analyse aber als Hinweisquelle. WDFIDF gewichtet Begriffe nach ihrer Häufigkeit im Text und ihrer Seltenheit im Vergleichsbestand. Ein Text mit passenden WDF*IDF-Werten erklärt ein Thema deshalb nicht automatisch vollständig oder verständlich.
Wann lohnt sich semantische Optimierung für bestehende Artikel?
Semantische Optimierung lohnt sich für bestehende Artikel, die bereits Rankings oder eingehende Links haben, aber nicht alle Teilthemen abdecken. Die Überarbeitung ergänzt fehlende Abschnitte, ersetzt Pronomen in Kernaussagen und schärft Überschriften. URL und eingehende Links bleiben dabei erhalten.
Wirkt semantische Optimierung auch außerhalb von Suchmaschinen?
Semantische Optimierung wirkt in jedem System, das Texte über Bedeutung abruft oder auswertet. Interne Suchfunktionen, Chatbots mit Retrieval und Wissensdatenbanken finden Passagen mit klaren Phrasen und benannten Entitäten zuverlässiger. Menschen erfassen solche Texte schneller, weil jeder Abschnitt sein Thema selbst nennt.
Wo stößt semantische Optimierung an Grenzen?
Semantische Optimierung verbessert die sprachliche Erschließung eines Themas, ersetzt aber kein fehlendes Fachwissen. Technische Hürden wie fehlende Indexierung oder lange Ladezeiten löst semantische Optimierung nicht. Autorität entsteht zusätzlich über externe Signale wie Verlinkungen und Erwähnungen, die außerhalb des Textes liegen.
Zentrale Erkenntnisse von Ralf Dodler zur semantischen Optimierung
„Ein Keyword sagt, worüber ein Text spricht, erst Phrasen zeigen, dass er das Thema verstanden hat.“
– Ralf Dodler, Generative SEO-Stratege
- Semantische Optimierung überarbeitet Inhalte nach Phrasen, Entitäten und Begriffsnachbarschaften statt nach Keyword-Häufigkeit.
- Typische Phrasen entstehen aus Suchintentionen und zeigen, wie ein Thema gemeint ist.
- Suchsysteme erkennen Phrasenmuster über N-Gramme, Co-Occurrence und Embeddings.
- Benannte Entitäten verankern Phrasen in einem eindeutigen Zusammenhang.
- AI-Search ruft einzelne Passagen ab, deshalb muss jeder Abschnitt seinen Kontext selbst nennen.
- Vergleichstexte, Tools und Sprachmodelle liefern Phrasen, die Auswahl bleibt redaktionelle Arbeit.
- Eine fehlende Phrase zeigt eine inhaltliche Lücke, die ein erklärender Absatz schließt.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).