Grounding in der KI: Wie Sprachmodelle Antworten an Quellen binden
Sprachmodelle formulieren auch dann flüssig und überzeugend, wenn ihnen die Fakten fehlen oder ihr Wissen veraltet ist. Nutzer sehen einer KI-Antwort deshalb nicht an, ob sie stimmt.
Grounding setzt an diesem Problem an. Der Ansatz bindet die Antworten von Sprachmodellen an Quellen, die das System zum Zeitpunkt der Anfrage abruft. Das ist die Grundlage für AI-Search und KI-Assistenten, die Antworten aus Dokumenten, Datenbanken und Webseiten zusammensetzen.
Grounding verbindet die Textgenerierung von Sprachmodellen mit dem Feld des Information Retrieval, das untersucht, wie Systeme relevante Informationen finden, bewerten und bereitstellen.
In diesem Artikel erfährst du, warum Sprachmodelle Grounding brauchen, welche Verfahren und Quellen es gibt, wo die Grenzen liegen und was Grounding für Inhalte im Web bedeutet.
Was ist Grounding in der KI?
Grounding ist die Verankerung der Antworten eines Sprachmodells (Large Language Model) in externen, überprüfbaren Daten wie Dokumenten, Datenbanken oder Knowledge Graphs. Grounding bindet die Textgenerierung an abgerufene Fakten, statt sie allein auf Wahrscheinlichkeiten aus den Trainingsdaten zu stützen.
Ein gegroundetes System beantwortet eine Frage also nicht aus dem Gedächtnis. Es sucht zuerst passende Informationen, gibt sie dem Sprachmodell als Kontext mit und lässt die Antwort auf dieser Grundlage formulieren. Die Quelle wird damit Teil der Antwort.
Grounding ist nicht dasselbe wie Reasoning. Grounding sichert, dass die Fakten stimmen. Reasoning beschreibt, wie ein Modell aus Fakten Schlüsse zieht. Wie beide Fähigkeiten zusammenspielen, zeigt der Artikel zu Grounding und Reasoning.
Auch von Fine-Tuning und Prompting unterscheidet sich Grounding. Fine-Tuning verändert das Modell selbst, Prompting steuert nur die Aufgabe. Grounding lässt das Modell unverändert und tauscht stattdessen die Wissensbasis jeder einzelnen Antwort aus.
| Merkmal | Grounding | Fine-Tuning | Prompting |
|---|---|---|---|
| Wissensquelle | abgerufene Daten zur Laufzeit | zusätzliche Trainingsdaten | Wissen im Modell und im Prompt |
| Aktualität | so aktuell wie die Quelle | Stand des letzten Trainings | Stand des Modells |
| Aufwand | Index und Abruf aufbauen | Training und Evaluation | gering |
| Nachprüfbarkeit | Quelle ist benennbar | keine Quelle je Aussage | keine Quelle je Aussage |
| Zweck | Fakten und aktuelles Wissen | Stil, Format, Fachsprache | Aufgabe und Ausgabeform |
Sprachmodelle brauchen Grounding
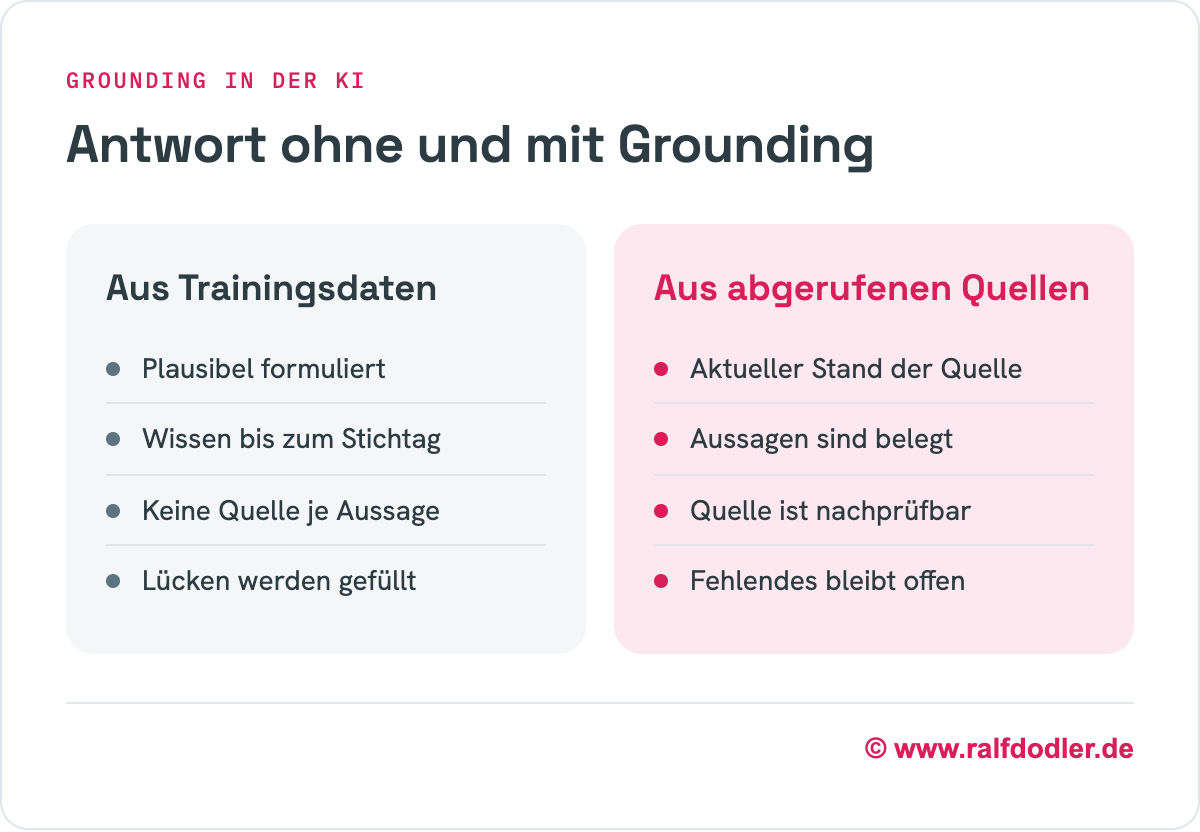
Sprachmodelle haben drei Eigenschaften, die ohne externe Quellen zu falschen Antworten führen. Sie rechnen mit Wahrscheinlichkeiten, ihr Wissen endet an einem Stichtag, und sie melden Wissenslücken nicht von selbst.
Sprachmodelle berechnen Wahrscheinlichkeiten
Sprachmodelle erzeugen Text, indem sie Wort für Wort das wahrscheinlichste nächste Token berechnen. Grundlage dafür sind statistische Muster aus den Trainingsdaten, nicht geprüfte Fakten.
Dieses Prinzip erklärt, warum Sprachmodelle so flüssig schreiben. Eine plausible Formulierung ist für das Modell aber dasselbe wie eine wahre. Das Modell prüft nicht, ob eine Aussage stimmt, sondern nur, ob sie sprachlich zum bisherigen Text passt.
Für allgemeines Wissen, das in den Trainingsdaten oft vorkommt, funktioniert das gut. Bei seltenen, konkreten oder neuen Fakten sinkt die Trefferquote. Genau dort setzt Grounding an: Es ersetzt Wahrscheinlichkeit durch eine abgerufene Quelle.
Trainingsdaten haben Stichtag
Jedes Sprachmodell kennt die Welt nur bis zu seinem Wissensstichtag. Alles, was danach passiert, fehlt in den Trainingsdaten und damit im Modell.
Das betrifft neue Produkte, geänderte Preise, aktuelle Gesetze und jede Nachricht nach dem Training. Ein Modell ohne Grounding beantwortet solche Fragen mit dem alten Stand oder mit einer Vermutung.
Dazu kommt Wissen, das nie öffentlich war. Interne Richtlinien, Produktdaten und Kundendokumente stehen in keinem Trainingsdatensatz. Ein Sprachmodell kann dieses Unternehmenswissen nur nutzen, wenn ein Grounding-Verfahren es zur Laufzeit bereitstellt.
Halluzinationen füllen Wissenslücken
Halluzinationen sind Aussagen eines Sprachmodells, die überzeugend klingen, aber nicht stimmen. Sie entstehen, wenn das Modell eine Wissenslücke mit wahrscheinlichem Text füllt.
Typisch sind erfundene Zahlen, falsche Daten, nicht existierende Studien und Quellenangaben ohne Quelle. Das Modell markiert solche Stellen nicht, weil es keinen Unterschied zwischen erinnertem und erzeugtem Wissen kennt.
Grounding senkt dieses Risiko, weil das Modell die Antwort an einen abgerufenen Text bindet. Fehlt eine Information in der Quelle, fehlt sie auch in der Antwort.
Grounding-Verfahren nutzen Datenquellen
Grounding ist kein einzelnes Verfahren, sondern ein Prinzip mit mehreren Umsetzungen. Die Verfahren unterscheiden sich vor allem in der Quelle, aus der sie Wissen abrufen: Dokumente, Wissensgraphen, das Web, Echtzeitdaten oder Bilder.
RAG ruft Dokumente ab
Retrieval-Augmented Generation (RAG) ist das verbreitetste Grounding-Verfahren. RAG durchsucht eine Dokumentensammlung nach passenden Textstellen und gibt sie dem Sprachmodell zusammen mit der Frage weiter.
Die Dokumente liegen dafür meist in einem Vektorindex. Das System wandelt Frage und Textstellen in Vektoren um und wählt die Passagen mit der größten Bedeutungsnähe. Das Sprachmodell formuliert die Antwort dann aus diesen Passagen.
RAG eignet sich für Handbücher, Richtlinien, Produktdaten und Wissensdatenbanken. Den Aufbau im Detail beschreibt der Artikel zu Retrieval-Augmented Generation. Mehrstufige Varianten, bei denen Agenten den Abruf selbst planen, heißen Agentic RAG.
Knowledge Graphs liefern Fakten
Knowledge Graphs liefern Grounding-Systemen eindeutige Fakten über Entitäten und ihre Beziehungen. Ein Knowledge Graph speichert Wissen als Verbindungen zwischen Personen, Organisationen, Orten und Begriffen.
Diese Struktur ergänzt den Textabruf. Ein Vektorindex findet ähnliche Passagen, ein Knowledge Graph beantwortet präzise Faktenfragen wie Gründungsjahr, Sitz oder Zugehörigkeit. Er löst außerdem Mehrdeutigkeiten auf, weil jede Entität eine feste Kennung hat.
Suchmaschinen nutzen dafür große öffentliche Graphen wie den Google Knowledge Graph. Warum Knowledge Graphs die strukturelle Grundlage des Groundings bilden, erklärt der Artikel zu Knowledge Graphs und Grounding.
Websuche ergänzt aktuelles Wissen
Die Websuche ist die Grounding-Quelle von AI-Search-Systemen. Das System schickt eine oder mehrere Suchanfragen an einen Suchindex, ruft die besten Treffer ab und formuliert daraus eine Antwort mit Quellenangaben.
Der Vorteil ist die Breite. Das Web deckt fast jedes Thema ab und wird laufend aktualisiert. Der Nachteil ist die schwankende Qualität: Das System muss aus vielen Seiten die verlässlichen auswählen.
Für Website-Betreiber hat dieses Verfahren direkte Folgen. Wer als Quelle ausgewählt wird, erscheint in der KI-Antwort. Die Optimierung für diesen Auswahlschritt ist ein Kern der Generative Engine Optimization (GEO).
| Quelle | liefert | Stärke | Grenze |
|---|---|---|---|
| Dokumente im Vektorindex | Textpassagen | internes Wissen, volle Kontrolle | nur so gut wie die Sammlung |
| Knowledge Graph | Fakten über Entitäten | eindeutig und strukturiert | deckt nur modellierte Fakten ab |
| Websuche | Webseiten und Passagen | breit und aktuell | schwankende Quellenqualität |
| Echtzeit-Schnittstellen | Messwerte und Zustände | Stand der Sekunde | nur für eng definierte Daten |
| Multimodale Daten | Bilder, Tabellen, Sensordaten | Wissen jenseits von Text | aufwendige Auswertung |
Echtzeitdaten sichern Aktualität
Echtzeit-Datenintegration verankert KI-Antworten in Daten, die sich laufend ändern. Das System fragt dafür zum Zeitpunkt der Anfrage eine Schnittstelle ab, etwa für Kurse, Verkehrslage, Wetter oder Lagerbestand.
Dokumentenindex und Websuche sind dafür zu langsam. Ein Index bildet den Stand der letzten Aktualisierung ab, eine Webseite den Stand ihrer letzten Bearbeitung. Eine Schnittstelle liefert den aktuellen Wert.
Technisch ruft das Sprachmodell dabei ein Werkzeug auf. Es erkennt, dass die Frage einen aktuellen Wert braucht, startet die Abfrage und baut das Ergebnis in die Antwort ein. Dieses Muster heißt Function Calling oder Tool Use.
Multimodale Daten erweitern Grounding
Multimodale Verankerung bindet KI-Antworten an Bilder, Tabellen, Diagramme oder Sensordaten statt nur an Text. Multimodale Modelle verarbeiten diese Datenarten gemeinsam mit der Frage.
Ein System beantwortet so Fragen zu einem Foto, einer technischen Zeichnung oder einer Messreihe. Die Antwort beruht dann auf dem, was in den Daten tatsächlich zu sehen ist, und nicht auf dem, was zu einem ähnlichen Bild wahrscheinlich wäre.
Für Inhalte im Web heißt das: Auch Grafiken und Tabellen werden zu Grounding-Quellen. Sie wirken aber nur, wenn ihre Aussage auch im Text steht. Viele Systeme extrahieren für den Abruf weiterhin vor allem Text.
Grounding verbindet Abruf und Generierung
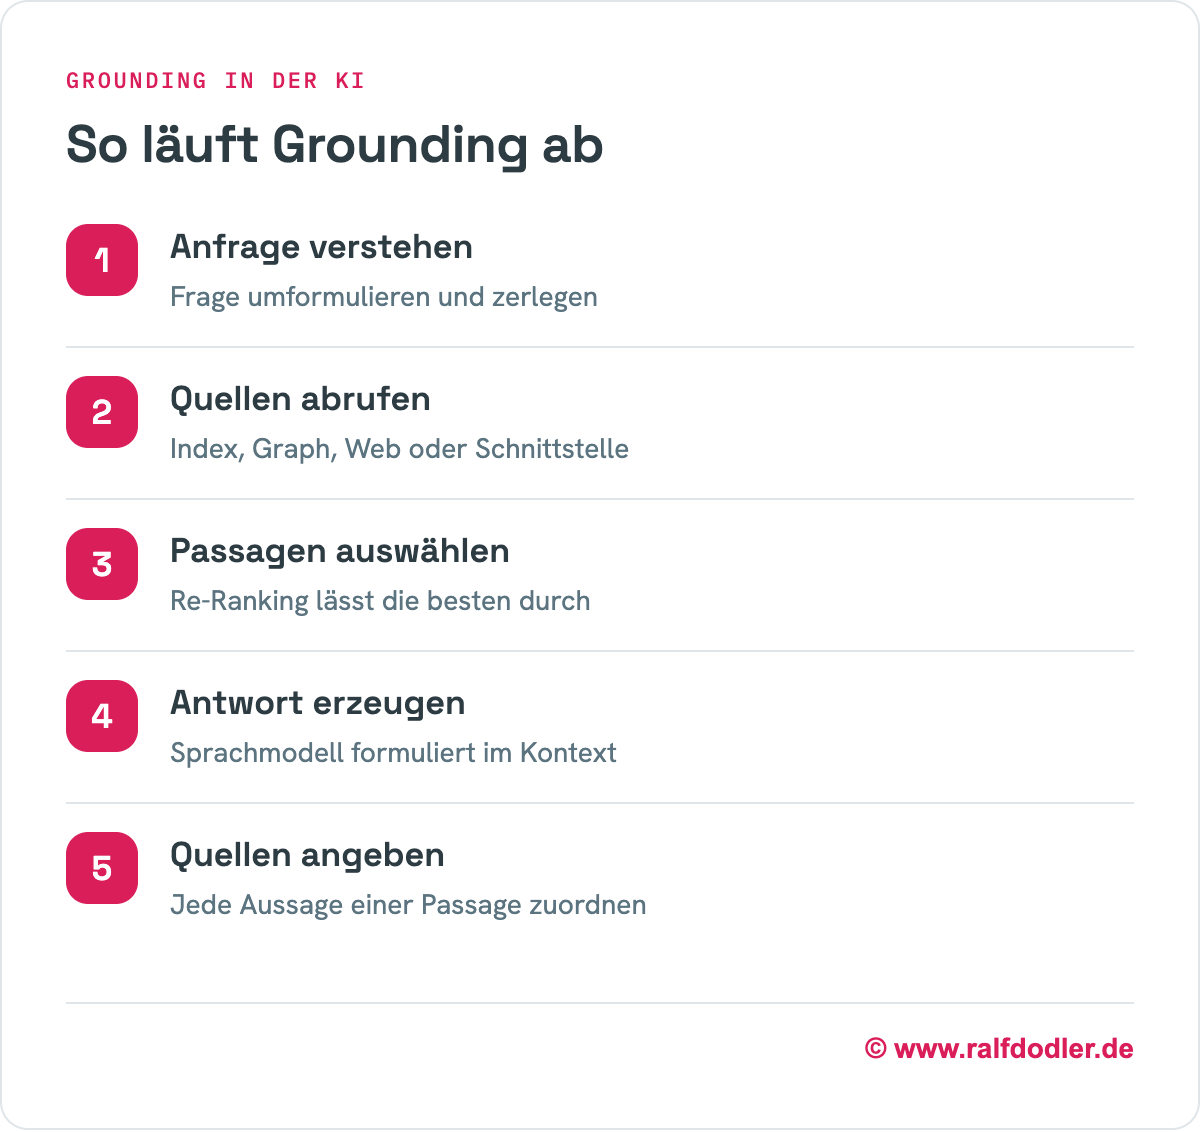
Unabhängig von der Quelle folgt Grounding einem festen Ablauf. Das System versteht die Anfrage, ruft Quellen ab, wählt die passenden Passagen aus, erzeugt die Antwort im Kontext dieser Passagen und gibt die Quellen an.
Anfragen lösen Retrieval aus
Am Anfang jedes Groundings steht der Abruf: Die Frage des Nutzers wird zur Suchanfrage an eine oder mehrere Quellen. Dieser Schritt entscheidet, welches Wissen das Sprachmodell überhaupt zu sehen bekommt.
Moderne Systeme formulieren die Frage dafür um oder zerlegen sie in Teilfragen. Dieses Verfahren heißt Query Fan-Out. Jede Teilfrage ruft eigene Treffer ab, das System führt sie anschließend zusammen.
Für den Abruf selbst kombinieren viele Systeme lexikalische Suche und Vector Retrieval. Die lexikalische Suche findet exakte Begriffe, die Vektorsuche findet Bedeutungsnähe. Fehlt die richtige Quelle in den Treffern, kann auch das beste Sprachmodell sie nicht nutzen.
Passagen gelangen ins Kontextfenster
Sprachmodelle verarbeiten beim Grounding nicht ganze Dokumente, sondern ausgewählte Passagen. Diese Passagen landen im Kontextfenster, also im Arbeitsspeicher des Modells für eine Antwort.
Dafür zerlegt das System Dokumente vorab in Abschnitte. Dieses Document Chunking bestimmt, welche Einheiten später abrufbar sind. Ein Re-Ranking ordnet die Treffer danach nach Relevanz und lässt nur die besten durch.
Die Auswahl auf Passagenebene heißt Passage Retrieval. Für die Antwortqualität zählt deshalb nicht nur, ob ein Dokument passt, sondern ob ein einzelner Abschnitt die Frage für sich beantwortet.
Quellenangaben machen Antworten prüfbar
Quellenangaben ordnen jede Aussage einer gegroundeten Antwort der Passage zu, aus der sie stammt. Damit wird die Antwort für Nutzer nachprüfbar.
AI-Search-Systeme zeigen diese Zuordnung als Fußnote, Link oder Quellenkarte. Der Nutzer sieht, welche Seite welche Aussage stützt, und kann die Quelle selbst lesen.
Die Quellenangabe ist auch ein Prüfwerkzeug für das System. Eine Aussage ohne passende Passage ist ein Warnsignal für eine Halluzination. Systeme mit strenger Zuordnung verwerfen solche Aussagen oder kennzeichnen sie.
Grounding stößt an Grenzen
Grounding macht KI-Antworten belegbar, aber nicht automatisch richtig. Die Qualität hängt an den Quellen, an ihrer Widerspruchsfreiheit und daran, ob das Modell den abgerufenen Kontext wirklich nutzt.
| Grenze | Ursache | Gegenmaßnahme |
|---|---|---|
| Schwache Quelle | veraltete oder falsche Seite im Abruf | Quellen nach Herkunft und Stand bewerten |
| Widersprüchliche Quellen | unterschiedliche Stände oder Definitionen | Datum und Quellentyp als Metadaten nutzen |
| Übergangener Kontext | Trainingswissen setzt sich durch | kurze Kontexte, Antwort gegen Quelle prüfen |
Schwache Quellen erzeugen Fehler
Grounding überträgt die Fehler seiner Quellen direkt in die Antwort. Ist eine abgerufene Seite veraltet oder falsch, gibt das Sprachmodell den Fehler belegt und mit Quellenangabe wieder.
Das macht den Fehler schwerer erkennbar. Eine Halluzination ohne Quelle weckt Zweifel, eine falsche Aussage mit Quelle wirkt geprüft.
Systeme bewerten Quellen deshalb vor der Nutzung. Sie bevorzugen Seiten mit klarer Herkunft, eindeutiger Entität und aktuellem Stand. Für Unternehmensdaten gilt dasselbe: Ein RAG-System mit veralteten Richtlinien liefert veraltete Antworten.
Widersprüchliche Quellen verunsichern Modelle
Widersprechen sich abgerufene Quellen, muss das Sprachmodell zwischen ihnen entscheiden. Ohne klare Regel wählt es eine Fassung, mischt beide oder nennt einen Mittelwert, den keine Quelle enthält.
Widersprüche entstehen durch unterschiedliche Stände, unterschiedliche Definitionen oder schlicht durch Fehler. Ein Preis von 2024 und einer von 2026 sind für das Modell zunächst gleichwertige Textstellen.
Gute Systeme lösen das über Metadaten wie Datum, Quellentyp und Vertrauensstufe. Für Inhalte im Web heißt das: Eine Website, die einen Begriff überall gleich definiert, wird eher als eindeutige Quelle genutzt als eine mit widersprüchlichen Angaben.
Modelle übergehen abgerufenen Kontext
Sprachmodelle nutzen abgerufenen Kontext nicht immer. Widerspricht die Quelle dem Trainingswissen, setzt sich manchmal das gelernte Wissen gegen die Quelle durch.
Das passiert vor allem bei bekannten Fakten, die sich geändert haben. Das Modell hat die alte Fassung tausendfach gesehen und die neue nur einmal im Kontext. Auch sehr lange Kontexte schwächen die Nutzung, weil Passagen in der Mitte weniger Gewicht bekommen.
Entwickler begegnen dem mit klaren Anweisungen, kurzen und relevanten Kontexten und einer Prüfung der Antwort gegen die Quelle. Grounding ist damit eine Architekturaufgabe und kein Schalter, den man einmal umlegt.
Websites werden Grounding-Quellen
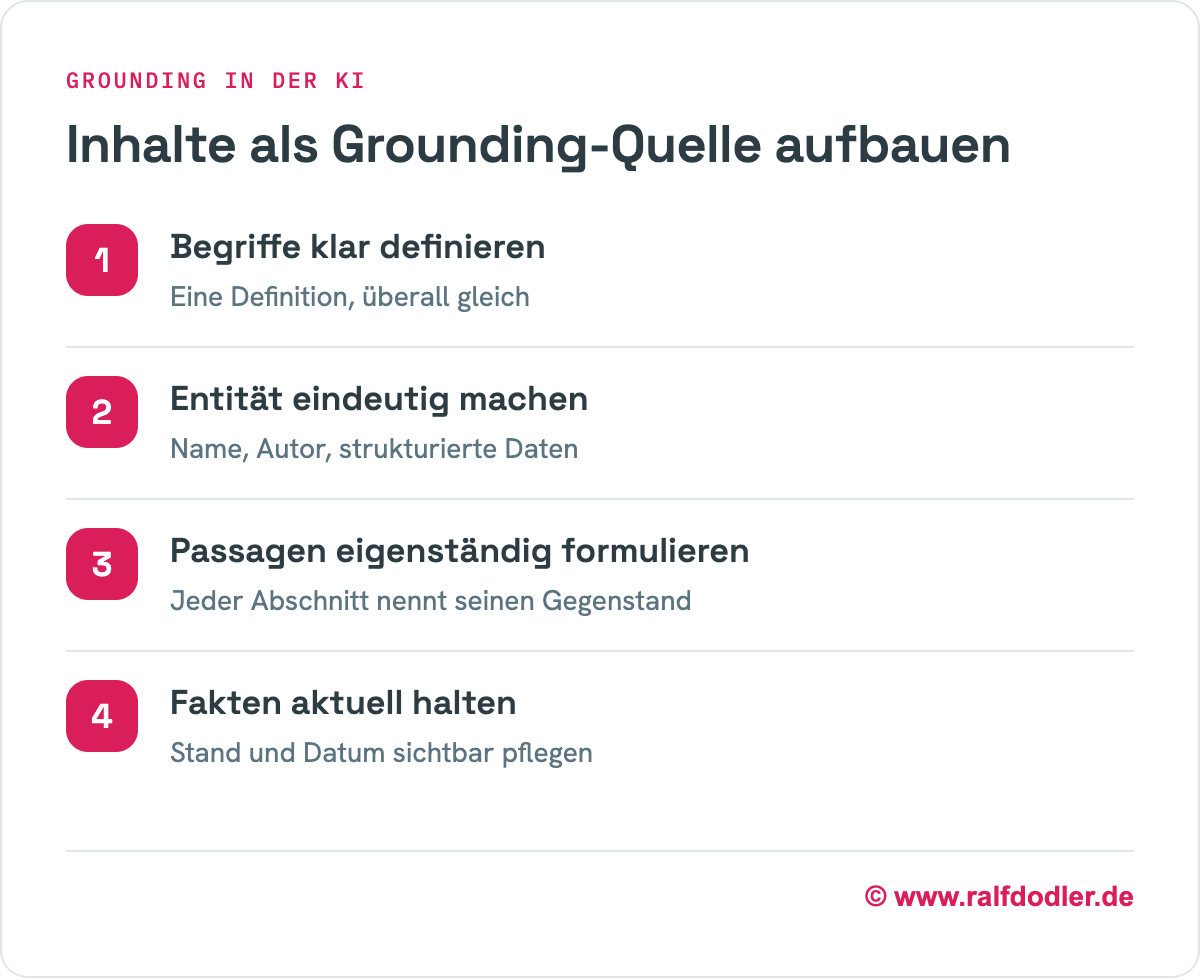
Wenn AI-Search-Systeme das Web als Wissensbasis nutzen, werden Websites zu Grounding-Quellen. Das Generative Authority Model von Ralf Dodler beschreibt die eindeutige Zuordnung von Wissen zu seiner Quelle als Entity Grounding. Grounding bindet eine Antwort an eine Quelle, Entity Grounding macht diese Quelle identifizierbar.
Eigenständige Passagen erleichtern Extraktion
Grounding-Systeme bevorzugen Passagen, die eine Frage ohne den Rest der Seite beantworten. Ein Abschnitt, der seinen Gegenstand selbst nennt und direkt antwortet, lässt sich sauber abrufen und zitieren.
Abschnitte, die auf vorherige Absätze verweisen, verlieren beim Chunking ihren Bezug. Ein Satz wie „Das verbessert die Ergebnisse“ ist allein nicht verständlich. Verfahren wie Contextual Retrieval versuchen, diesen Bezug nachträglich zu ergänzen.
Eindeutige Begriffe, kurze Sätze und eine klare Überschrift je Abschnitt machen Inhalte extrahierbar. Strukturierte Daten ergänzen den Text um maschinenlesbare Fakten über Entitäten, Autoren und Beziehungen.
Grounding Pages bündeln Kernfakten
Eine Grounding Page ist eine Seite, die die Kernfakten einer Entität an einer Stelle maschinenlesbar bündelt. Sie liefert Grounding-Systemen eine verlässliche Referenz für Fragen nach einer Person, Marke oder Organisation.
Typische Inhalte sind Name, Rolle, Tätigkeitsfeld, Gründungsdaten und Verbindungen zu anderen Profilen. Strukturierte Daten bestätigen diese Angaben in einer Form, die Maschinen direkt lesen.
Ohne eine solche Seite setzt ein System die Fakten aus verstreuten Quellen zusammen. Das erhöht das Risiko von Widersprüchen und Verwechslungen. Wie eine Grounding Page aufgebaut ist, beschreibt der eigene Artikel dazu.
Entitäten machen Quellen zitierfähig
AI-Search-Systeme zitieren Quellen, die sie einer eindeutigen Entität zuordnen können. Anonymes Wissen wird zwar abgerufen, aber seltener als Quelle genannt.
Die Zuordnung entsteht durch konsistente Namen, Autorenangaben, strukturierte Metadaten und Verweise auf externe Profile. Suchsysteme verbinden diese Signale über Entity Linking mit Einträgen im Knowledge Graph.
Für Marken und Experten ist das der Hebel in der generativen Suche. Wer als Entität erkennbar ist, wird bei passenden Fragen als Quelle herangezogen. Wie Marken diese Erkennbarkeit aufbauen, zeigt der Artikel zu Entity Grounding.
Verwandte Themen
Grounding verbindet Sprachmodelle mit Information Retrieval und bildet die Grundlage moderner AI-Search-Systeme. Die Verfahren reichen vom Dokumentabruf über Knowledge Graphs bis zur Websuche, die Wirkung reicht bis zur Frage, welche Websites als Quelle zitiert werden.
Wichtige verwandte Themen sind:
- Grounding vs. Reasoning
- Retrieval-Augmented Generation
- Knowledge Graphs und Grounding
- Grounding Page
- Entity Grounding
- Generative Engine Optimization
- Halluzinationen in Sprachmodellen
FAQ zu Grounding in der KI
Braucht jedes KI-System Grounding?
Grounding ist nur für KI-Aufgaben nötig, deren Ergebnis von Fakten abhängt. Kreative Texte, Umformulierungen und Übersetzungen beruhen auf Sprachkompetenz und kommen ohne externe Quelle aus. Sobald eine Antwort einen überprüfbaren Sachverhalt behauptet, braucht das System eine Quelle, an der sich diese Behauptung messen lässt.
Was passiert, wenn ein Grounding-System keine passende Quelle findet?
Ein Grounding-System ohne passende Quelle fällt auf das Trainingswissen des Sprachmodells zurück oder verzichtet auf eine Antwort. Der Rückfall erzeugt wieder ungeprüfte Aussagen mit dem Risiko von Halluzinationen. Zuverlässige Systeme melden deshalb ausdrücklich, dass die verfügbaren Quellen die Frage nicht beantworten.
Wie wirkt sich Grounding auf Antwortzeit und Kosten aus?
Grounding verlängert die Antwortzeit und erhöht die Kosten, weil jeder Anfrage ein Abruf vorausgeht. Suche, Re-Ranking und ein längerer Kontext verbrauchen Rechenzeit und Tokens. Dem stehen geringere Folgekosten gegenüber, weil gegroundete Systeme weniger falsche Antworten erzeugen.
Wie schützt Grounding vertrauliche Daten?
Grounding schützt vertrauliche Daten nur, wenn der Abruf die Zugriffsrechte des fragenden Nutzers prüft. Ein Index ohne Rechteprüfung gibt jedem Nutzer jede indexierte Passage weiter, auch interne Dokumente. Sichere Grounding-Architekturen filtern die Treffer deshalb vor der Übergabe an das Sprachmodell nach Berechtigungen.
Worin unterscheidet sich Grounding von nachträglicher Faktenprüfung?
Grounding stellt die Fakten vor der Generierung bereit, eine nachträgliche Faktenprüfung kontrolliert eine bereits erzeugte Antwort. Grounding verhindert Fehler an der Quelle, die Faktenprüfung findet Fehler im Ergebnis. Robuste KI-Systeme kombinieren beide Schritte und gleichen die fertige Antwort noch einmal mit den abgerufenen Passagen ab.
Zentrale Erkenntnisse von Ralf Dodler zu Grounding in der KI
„Ein Sprachmodell ohne Grounding weiß nicht, was es nicht weiß, erst die Quelle macht aus einer plausiblen Antwort eine prüfbare.“
– Ralf Dodler, Generative SEO-Stratege
- Grounding verankert die Antworten von Sprachmodellen in externen, überprüfbaren Daten statt in Wahrscheinlichkeiten aus dem Training.
- Sprachmodelle kennen die Welt nur bis zu ihrem Wissensstichtag und melden Wissenslücken nicht von selbst.
- Retrieval-Augmented Generation, Knowledge Graphs, Websuche, Echtzeitdaten und multimodale Daten sind die Quellen des Groundings.
- Jede gegroundete Antwort entsteht aus Abruf, Passagenauswahl, Generierung im Kontext und Quellenangabe.
- Grounding überträgt die Fehler schwacher oder widersprüchlicher Quellen direkt in die Antwort.
- AI-Search-Systeme machen Websites zu Grounding-Quellen und zitieren bevorzugt eigenständige, eindeutige Passagen.
- Eine eindeutig erkennbare Entität entscheidet mit darüber, ob eine Website als Quelle genannt wird.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).