Retrieval-Evaluation: Wie Suchsysteme die Qualität ihrer Ergebnisse messen
Ein Suchsystem liefert auf jede Anfrage eine Ergebnisliste, aber ob diese Liste gut ist, sieht man ihr nicht an. Wer ein Ranking anpasst, ein Embedding-Modell tauscht oder ein Re-Ranking einführt, braucht deshalb eine Zahl, die Verbesserung von Verschlechterung trennt.
Retrieval-Evaluation liefert diese Zahl. Sie verbindet Relevanzurteile mit Metriken wie Precision, Recall, MRR und nDCG und macht so messbar, ob ein Suchsystem die richtigen Dokumente findet und an die richtige Stelle setzt. Das gilt für klassische Suchmaschinen ebenso wie für die Retrieval-Stufe von AI-Search-Systemen.
Retrieval-Evaluation gehört zum größeren Feld des Information Retrieval, das untersucht, wie Suchsysteme relevante Informationen finden, bewerten und bereitstellen.
In diesem Artikel erfährst du, wie eine Testkollektion aufgebaut ist, wie Precision, Recall, MRR, Average Precision und nDCG rechnen und welche Metrik zu welcher Stufe einer Retrieval-Pipeline passt.
Was ist Retrieval-Evaluation?
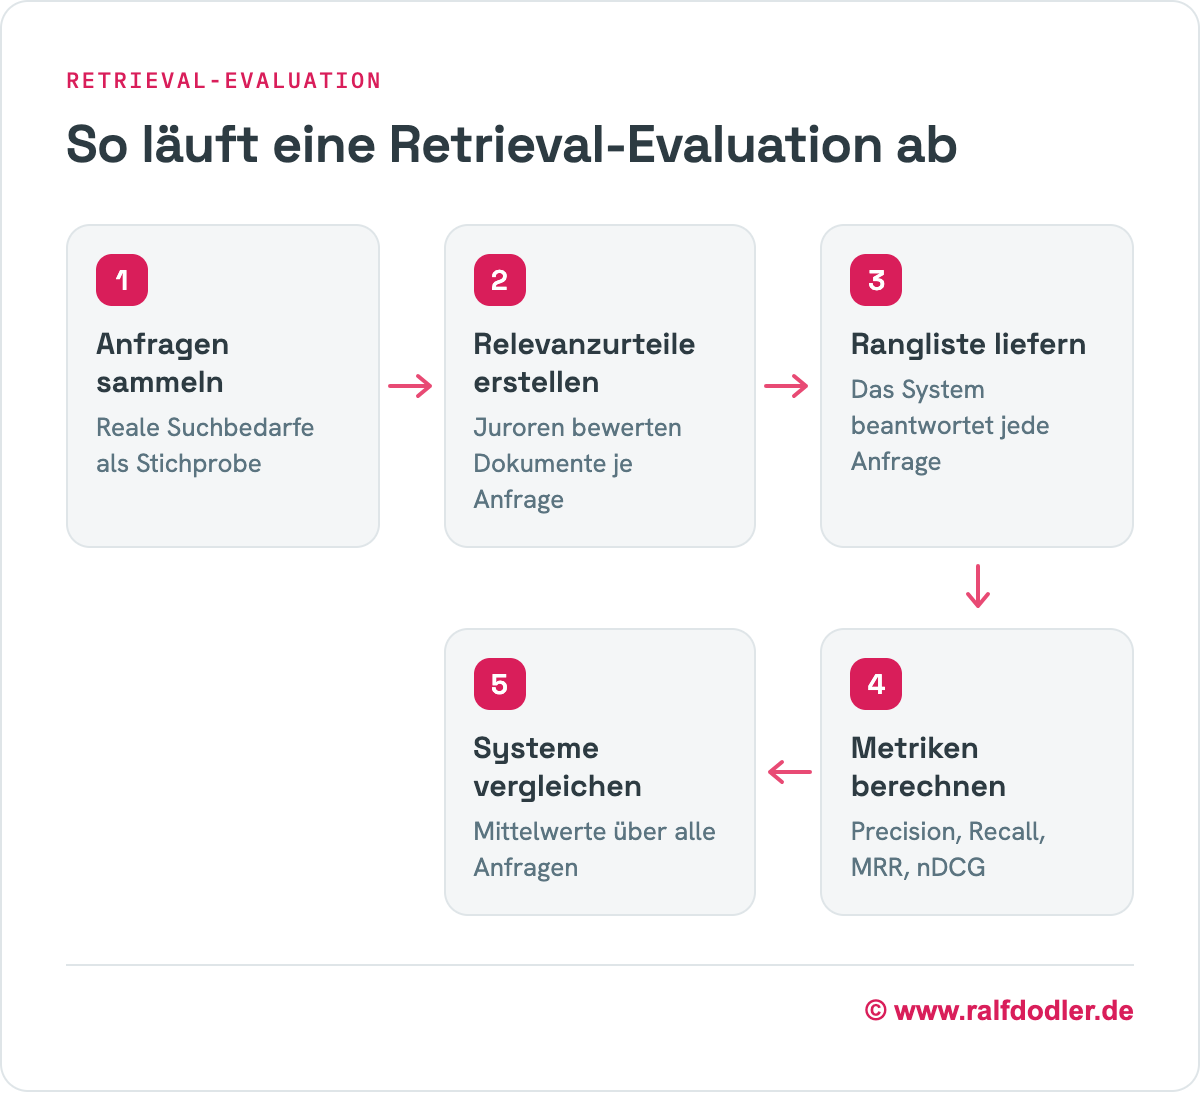
Retrieval-Evaluation ist die systematische Messung der Ergebnisqualität eines Suchsystems auf Grundlage von Relevanzurteilen zu Anfrage-Dokument-Paaren. Retrieval-Evaluation misst, wie viele relevante Dokumente ein Suchsystem findet und wie weit oben es sie in der Rangliste platziert.
Die Methode geht auf die Cranfield-Experimente der 1960er-Jahre zurück. Dort wurde erstmals eine feste Sammlung aus Dokumenten, Anfragen und Relevanzurteilen genutzt, um verschiedene Indexierungsverfahren unter gleichen Bedingungen zu vergleichen. Seit 1992 führt die Text Retrieval Conference (TREC) dieses Prinzip in großem Maßstab fort. Retrieval-Evaluation ist damit eine der ältesten Methoden des Information Retrieval.
Zwei Formen stehen nebeneinander. Die Offline-Evaluation misst ein System mit einer Testkollektion, bevor es live geht. Die Online-Messung beobachtet echte Nutzer und ihr Verhalten. Beide Formen bewerten letztlich, wie gut eine Retrieval Pipeline aus vielen Dokumenten die passenden auswählt und ordnet.
Woraus besteht eine Testkollektion?
Eine Testkollektion besteht aus drei Teilen: einem Dokumentkorpus, einer Menge von Anfragen und Relevanzurteilen, die festlegen, welches Dokument zu welcher Anfrage passt. Ohne diese drei Teile bleibt jede Metrik eine leere Formel.
Anfragen bilden Suchbedarfe ab
Die Anfragen einer Testkollektion bilden die realen Suchbedarfe ab, für die ein System gebaut ist. Sie sind eine Stichprobe aus dem, was Nutzer tatsächlich suchen.
Eine gute Stichprobe mischt kurze und lange Anfragen, eindeutige und mehrdeutige, häufige und seltene. Ein System, das nur auf kurzen Navigationsanfragen getestet wird, kann bei komplexen Fragen trotzdem scheitern.
Die Zahl der Anfragen entscheidet über die Verlässlichkeit. Metriken schwanken stark von Anfrage zu Anfrage. Erst der Mittelwert über Dutzende oder Hunderte Anfragen zeigt, ob ein System wirklich besser ist oder nur bei einzelnen Anfragen Glück hatte.
Relevanzurteile legen Ground Truth fest
Relevanzurteile legen fest, welche Dokumente für eine Anfrage als richtige Antwort gelten. Sie sind die Ground Truth, an der jede Metrik gemessen wird.
Urteile sind binär oder abgestuft. Binär heißt: relevant oder nicht relevant. Abgestuft heißt zum Beispiel: 0 für irrelevant, 1 für teilweise relevant, 2 für relevant und 3 für hoch relevant. Menschliche Juroren vergeben diese Urteile, und sie sind sich nicht immer einig.
Große Korpora lassen sich nicht vollständig beurteilen. Testkollektionen nutzen deshalb Pooling: Mehrere Systeme liefern ihre besten Treffer, und nur dieser Pool wird beurteilt. Dokumente außerhalb des Pools gelten als irrelevant.
| Rang | Dokument | Relevanzgrad | Relevant |
|---|---|---|---|
| 1 | A | 0 | nein |
| 2 | B | 3 | ja |
| 3 | C | 1 | ja |
| 4 | D | 0 | nein |
| 5 | E | 2 | ja |
| 6 | F | 0 | nein |
| 7 | G | 0 | nein |
| 8 | H | 1 | ja |
| 9 | I | 0 | nein |
| 10 | J | 0 | nein |
Im Korpus gibt es fünf relevante Dokumente. Das fünfte, Dokument K mit Relevanzgrad 2, fehlt in den Top 10. Alle Rechnungen in diesem Artikel beziehen sich auf diese Rangliste.
Offline- und Online-Evaluation ergänzen sich
Offline- und Online-Evaluation ergänzen sich, weil sie verschiedene Fragen beantworten. Die Offline-Evaluation prüft mit einer Testkollektion, ob ein System relevante Dokumente findet. Die Online-Evaluation prüft, ob echte Nutzer mit den Ergebnissen zufrieden sind.
Online-Verfahren arbeiten mit Klicks, Verweildauer und Abbrüchen. A/B-Tests zeigen zwei Nutzergruppen verschiedene Systeme. Interleaving mischt die Ergebnisse zweier Systeme in einer Liste und zählt, welche Treffer häufiger angeklickt werden.
Klicks sind allerdings verzerrt. Nutzer klicken bevorzugt auf die oberen Plätze, unabhängig von der Relevanz. Dieser Position Bias macht Klickdaten ohne Korrektur zu einem schwachen Relevanzsignal. Offline-Metriken bleiben deshalb die Grundlage, um Systeme vor dem Einsatz zu vergleichen.
Was messen Precision und Recall?
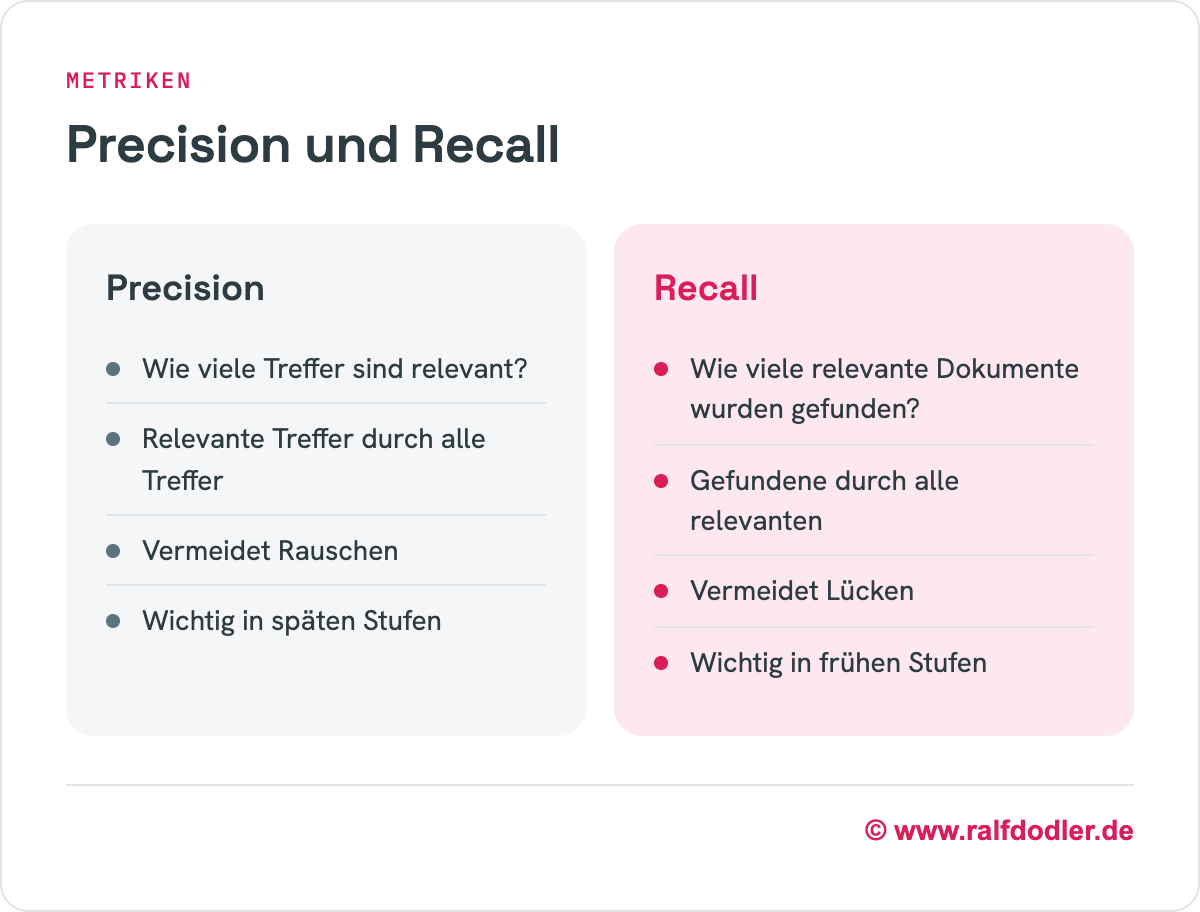
Precision misst den Anteil relevanter Treffer an allen gelieferten Treffern, Recall den Anteil gefundener Dokumente an allen relevanten Dokumenten. Die beiden Metriken betrachten eine Ergebnisliste als Menge und beantworten zwei verschiedene Fragen.
Precision misst Treffergenauigkeit
Precision misst, wie genau ein Suchsystem trifft. Sie ist die Zahl der relevanten Treffer, geteilt durch die Zahl aller gelieferten Treffer.
Im Rechenbeispiel sind unter den ersten fünf Treffern drei relevant. Die Precision@5 beträgt also 3 von 5, das ergibt 0,6. Unter den ersten zehn Treffern sind vier relevant, die Precision@10 liegt bei 0,4.
Eine hohe Precision bedeutet wenig Rauschen. Nutzer und Sprachmodelle müssen weniger irrelevante Treffer aussortieren. Precision ist deshalb vor allem für die späten Stufen eines Suchsystems wichtig, deren Ergebnisse direkt angezeigt oder weiterverarbeitet werden.
Recall misst Vollständigkeit
Recall misst, wie vollständig ein Suchsystem die relevanten Dokumente findet. Er ist die Zahl der gefundenen relevanten Dokumente, geteilt durch die Zahl aller relevanten Dokumente im Korpus.
Im Rechenbeispiel gibt es fünf relevante Dokumente. Die ersten fünf Treffer enthalten drei davon, der Recall@5 beträgt 0,6. Die ersten zehn Treffer enthalten vier, der Recall@10 liegt bei 0,8. Dokument K fehlt und verhindert den Wert 1.
Recall braucht die Gesamtzahl relevanter Dokumente. Genau diese Zahl ist in großen Korpora schwer zu bestimmen. Ein hoher Recall bedeutet wenig Lücken: Was später fehlt, kann keine nachfolgende Stufe mehr zurückholen.
Precision und Recall konkurrieren
Precision und Recall konkurrieren miteinander. Ein System, das mehr Treffer liefert, findet mehr relevante Dokumente und hebt den Recall. Gleichzeitig rutschen mehr irrelevante Treffer in die Liste, und die Precision sinkt.
Das Rechenbeispiel zeigt den Effekt. Von fünf auf zehn Treffer steigt der Recall von 0,6 auf 0,8, die Precision fällt von 0,6 auf 0,4. Verfahren wie die Query Expansion verschieben dieses Gleichgewicht bewusst in Richtung Recall, weil sie die Anfrage um verwandte Begriffe erweitern.
Wer beide Werte in einer Zahl braucht, nutzt den F1-Wert, das harmonische Mittel aus Precision und Recall. Er ist nur hoch, wenn beide Werte hoch sind.
| Cut-off | Relevante Treffer | Precision | Recall |
|---|---|---|---|
| k = 5 | 3 | 0,6 | 0,6 |
| k = 10 | 4 | 0,4 | 0,8 |
Warum zählt die Position im Ranking?
Die Position im Ranking zählt, weil Nutzer und Sprachmodelle nur die obersten Treffer wirklich nutzen. Precision und Recall ignorieren die Reihenfolge innerhalb einer Liste. Rangbasierte Metriken schließen diese Lücke und belohnen relevante Treffer auf den vorderen Plätzen.
Cut-off-Werte begrenzen Ranglisten
Cut-off-Werte begrenzen die Rangliste, die eine Metrik betrachtet. Precision@k und Recall@k werten nur die ersten k Treffer aus.
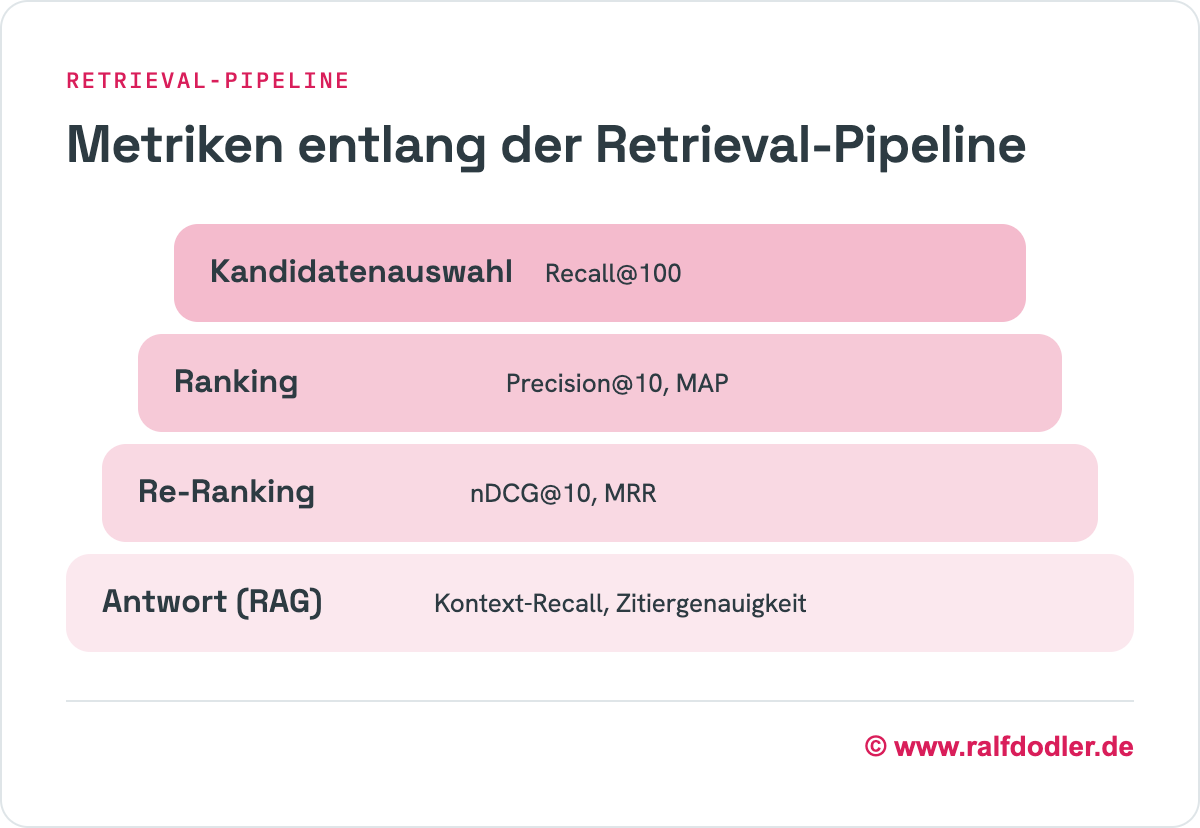
Der passende Wert für k hängt von der Stufe ab. Eine Ergebnisseite zeigt etwa zehn Treffer, also ist k = 10 sinnvoll. Ein Sprachmodell erhält oft nur fünf Passagen als Kontext, dann zählt k = 5. Die Candidate Generation reicht dagegen Hunderte Kandidaten weiter, dort wird mit k = 100 gemessen.
Der Cut-off macht Metriken erst vergleichbar. Ohne festen Wert für k würde ein System mit längerer Liste beim Recall automatisch gewinnen.
Mean Reciprocal Rank bewertet Ersttreffer
Der Mean Reciprocal Rank (MRR) bewertet, wie weit oben der erste relevante Treffer steht. Für jede Anfrage wird der Kehrwert seines Rangs berechnet, der Reciprocal Rank. MRR ist der Mittelwert dieser Kehrwerte über alle Anfragen.
Im Rechenbeispiel steht der erste relevante Treffer auf Rang 2. Der Reciprocal Rank beträgt 1 durch 2, also 0,5. Stünde er auf Rang 1, wäre der Wert 1. Auf Rang 10 läge er bei 0,1.
MRR passt zu Anfragen mit einer einzigen richtigen Antwort, etwa zur Suche nach einer bestimmten Seite oder einem Fakt. Alle weiteren relevanten Treffer ignoriert die Metrik.
Average Precision belohnt frühe Treffer
Average Precision belohnt Ranglisten, die relevante Treffer früh zeigen. Sie berechnet die Precision an jeder Stelle, an der ein relevantes Dokument steht, und mittelt diese Werte über alle relevanten Dokumente.
Im Rechenbeispiel liegen relevante Treffer auf den Rängen 2, 3, 5 und 8. Die Precision an diesen Stellen beträgt 0,5, 0,667, 0,6 und 0,5. Die Summe wird durch fünf geteilt, weil es fünf relevante Dokumente gibt. Das fehlende Dokument K zählt mit 0. Die Average Precision liegt bei 0,453.
Der Mittelwert über viele Anfragen heißt Mean Average Precision (MAP). MAP verbindet Precision und Recall in einer Zahl und gewichtet zugleich die Position.
Was ist nDCG?
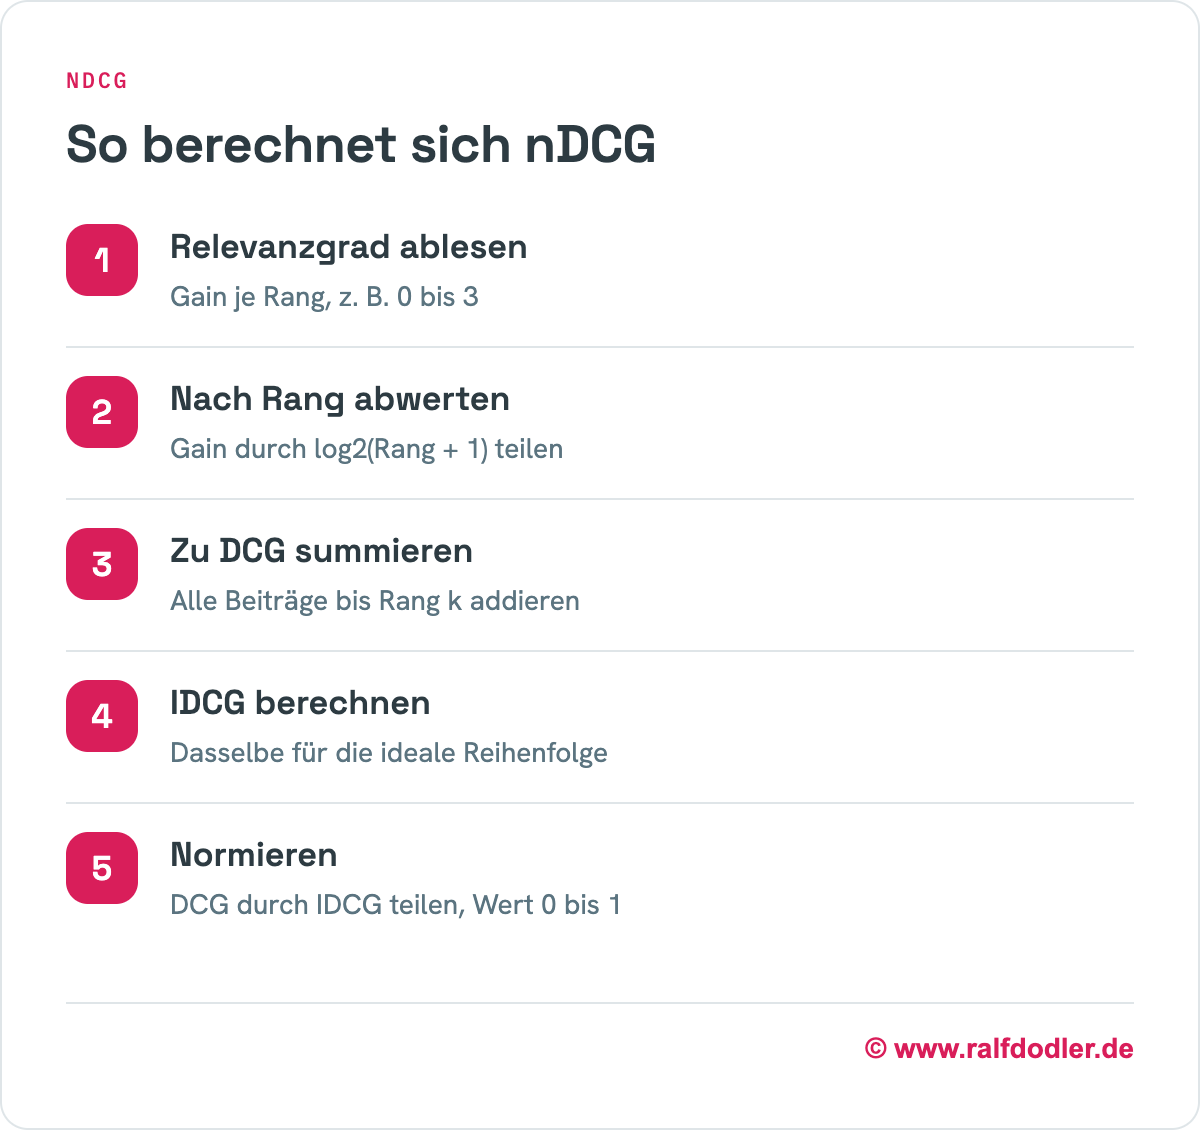
nDCG (Normalized Discounted Cumulative Gain) ist eine Metrik, die abgestufte Relevanz und Position zugleich bewertet und das Ergebnis auf die ideale Rangfolge normiert. nDCG liegt zwischen 0 und 1 und ist das Standardmaß moderner Retrieval-Benchmarks.
Discounted Cumulative Gain gewichtet Ränge
Discounted Cumulative Gain (DCG) gewichtet jeden Treffer nach seinem Rang. Der Relevanzgrad eines Dokuments ist sein Gewinn, der Gain. Dieser Gain wird durch den Logarithmus zur Basis 2 von Rang plus 1 geteilt.
Rang 1 behält seinen vollen Gain, weil log2(2) gleich 1 ist. Auf Rang 3 wird durch 2 geteilt, auf Rang 7 durch 3. Ein hoch relevantes Dokument weit unten bringt so weniger als eines weit oben.
Im Rechenbeispiel tragen nur die Ränge 2, 3 und 5 zum DCG@5 bei: Dokument B mit 1,893, Dokument C mit 0,5 und Dokument E mit 0,774. Der DCG@5 beträgt 3,166.
Normierung macht Anfragen vergleichbar
Die Normierung macht nDCG über Anfragen hinweg vergleichbar. Der rohe DCG hängt davon ab, wie viele relevante Dokumente eine Anfrage hat. Eine Anfrage mit vielen hoch relevanten Dokumenten erreicht automatisch höhere Werte.
Deshalb wird der DCG durch den idealen DCG (IDCG) geteilt. Der IDCG ist der Wert der bestmöglichen Rangfolge. Im Rechenbeispiel lautet sie 3, 2, 2, 1, 1, weil das fehlende Dokument K mit Grad 2 dazugehört. Der IDCG@5 beträgt 6,079.
Der nDCG@5 ergibt sich als 3,166 geteilt durch 6,079, also 0,521. Ein Wert von 1 bedeutet die ideale Reihenfolge, 0 bedeutet keinen relevanten Treffer in den ersten k Plätzen.
| Rang | Relevanzgrad | Abzug log2(Rang+1) | Beitrag zum DCG | Ideale Rangfolge | Beitrag zum IDCG |
|---|---|---|---|---|---|
| 1 | 0 | 1,000 | 0,000 | 3 | 3,000 |
| 2 | 3 | 1,585 | 1,893 | 2 | 1,262 |
| 3 | 1 | 2,000 | 0,500 | 2 | 1,000 |
| 4 | 0 | 2,322 | 0,000 | 1 | 0,431 |
| 5 | 2 | 2,585 | 0,774 | 1 | 0,387 |
| Summe | DCG@5 = 3,166 | IDCG@5 = 6,079 |
Welche Metrik passt zu welcher Aufgabe?
Welche Metrik passt, hängt von der Stufe der Suche und von der Art der Anfrage ab. Frühe Stufen müssen vollständig sein, späte Stufen genau und gut sortiert. Der Vergleich zeigt, was jede Metrik misst und wofür sie eingesetzt wird.
| Metrik | Misst | Relevanz | Position berücksichtigt | Wert im Beispiel | Typischer Einsatz |
|---|---|---|---|---|---|
| Precision@k | Anteil relevanter Treffer | binär | nein | 0,6 (k = 5) | Ergebnisseiten, RAG-Kontext |
| Recall@k | Anteil gefundener relevanter Dokumente | binär | nein | 0,8 (k = 10) | Kandidatenauswahl, ANN-Index |
| MRR | Rang des ersten relevanten Treffers | binär | ja | 0,5 | Navigations- und Faktenanfragen |
| MAP | Precision an allen Fundstellen | binär | ja | 0,453 | Vergleich ganzer Ranglisten |
| nDCG@k | Gain nach Rang, normiert | abgestuft | ja | 0,521 (k = 5) | Re-Ranking, Benchmarks |
Frühe Pipeline-Stufen optimieren Recall
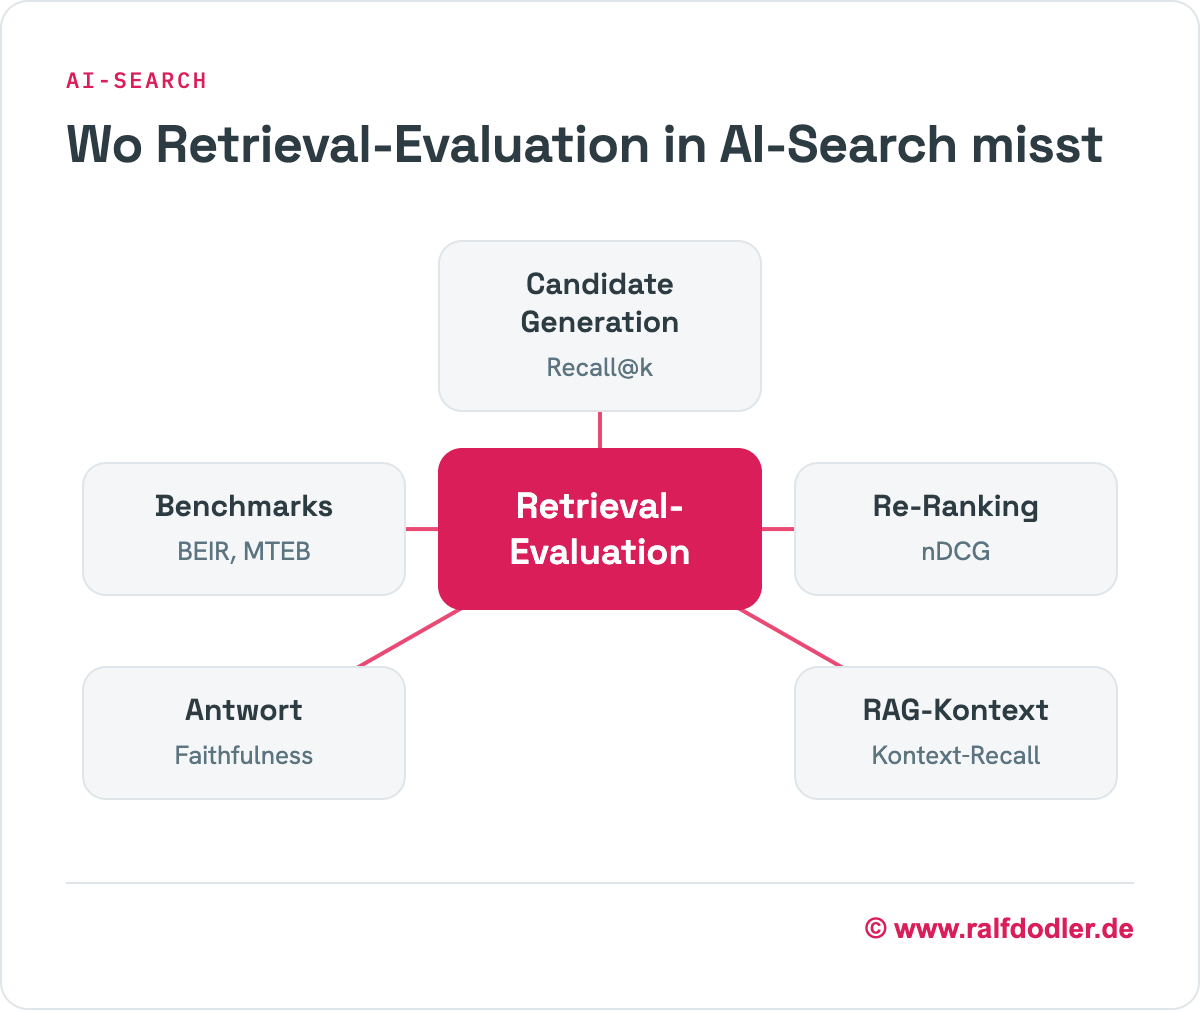
Frühe Stufen einer Suche optimieren Recall@k, weil sie keine relevanten Dokumente verlieren dürfen. Die Kandidatenauswahl reduziert Millionen Dokumente auf einige Hundert. Was dabei herausfällt, ist für alle folgenden Stufen verloren.
Die Precision ist hier zweitrangig. Irrelevante Kandidaten sortiert das spätere Ranking aus. Fehlende relevante Kandidaten kann es nicht ergänzen.
Auch die Approximate Nearest Neighbor Search wird über Recall gemessen, allerdings in einem eigenen Sinn. Dort vergleicht Recall@k die Treffer des Näherungsverfahrens mit denen einer exakten Suche. Er zeigt, wie viel Genauigkeit der schnellere Index kostet. In der Retrieval Pipeline ist Recall damit die Leitmetrik der ersten Stufen.
Re-Ranking optimiert nDCG und MRR
Re-Ranking optimiert nDCG und MRR, weil es die Reihenfolge der besten Kandidaten bestimmt. Die Menge der Kandidaten steht zu diesem Zeitpunkt fest, Recall ändert sich also nicht mehr.
Ein Re-Ranker verändert nur die Positionen. Genau das messen rangbasierte Metriken. Steigt nDCG@10 nach dem Re-Ranking, stehen hoch relevante Dokumente weiter oben als vorher.
Ein Cross-Encoder liest Anfrage und Dokument gemeinsam und bewertet die Relevanz genauer als die erste Stufe. Sein Nutzen zeigt sich in nDCG und MRR, nicht in Recall.
Benchmarks vergleichen Modelle
Benchmarks vergleichen Retrieval-Modelle auf vielen Testkollektionen zugleich. BEIR bündelt Datensätze aus verschiedenen Themenfeldern, MTEB prüft Embeddings über viele Aufgaben, darunter Retrieval. Beide nutzen vor allem nDCG@10 als Leitmetrik.
Benchmarks sind nützlich, um Modelle vorzuwählen. Sie zeigen, welches Modell über viele Themenfelder hinweg robust abschneidet.
Ein Benchmarkwert überträgt sich aber nicht eins zu eins auf eigene Inhalte. Fachsprache, Dokumentlänge und Anfragetypen weichen vom Benchmark ab. Wer ein Modell einsetzt, prüft es deshalb mit einer kleinen eigenen Testkollektion.
Was bedeutet Retrieval-Evaluation für AI-Search?
Retrieval-Evaluation bedeutet für AI-Search, dass die Qualität einer generierten Antwort mit der Qualität der abgerufenen Passagen beginnt. Ein Inhalt, der nicht unter den Top-k-Kandidaten landet, existiert für die Antwort nicht. Das Generative Authority Model (GAM) von Ralf Dodler beschreibt diese Abrufbarkeit als Retrieval Activation.
RAG-Systeme messen Kontext-Recall
RAG-Systeme messen den Kontext-Recall, also den Anteil der benötigten Informationen, die im Kontextfenster ankommen. Bei Retrieval-Augmented Generation erhält das Sprachmodell nur die obersten Passagen als Kontext.
Was dort fehlt, kann das Modell weder verwenden noch zitieren. Ein relevanter Abschnitt auf Rang 12 ist bei einem Kontext von zehn Passagen genauso unsichtbar wie ein Abschnitt, der gar nicht gefunden wurde.
Kontext-Recall verbindet damit die klassische Metrik mit dem Kontextfenster. Er zeigt, ob die Retrieval-Stufe dem Modell alles liefert, was es für eine vollständige Antwort braucht.
Antwortqualität braucht eigene Metriken
Die Qualität einer generierten Antwort braucht eigene Metriken, weil Retrieval-Metriken nur die Zulieferung messen. Ein System kann die richtigen Passagen abrufen und trotzdem eine falsche Antwort formulieren.
Faithfulness misst, ob jede Aussage der Antwort durch die abgerufenen Passagen gedeckt ist. Zitiergenauigkeit misst, ob die angegebenen Quellen die jeweilige Aussage tatsächlich belegen.
Beide Metriken prüfen das Grounding einer Antwort, also ihre Verankerung in den Quellen. Retrieval-Metriken und Antwortmetriken zusammen zeigen, an welcher Stelle ein RAG-System scheitert: beim Finden oder beim Formulieren.
Inhalte gewinnen im Top-k-Fenster
Inhalte gewinnen im Top-k-Fenster, wenn eine Passage eine Anfrage direkt beantwortet. Genau solche Passagen bewerten Juroren und Re-Ranker als hoch relevant, und sie verbessern Precision@k und nDCG eines Systems.
AI-Search-Systeme bewerten nicht ganze Seiten, sondern einzelne Abschnitte. Wie Systeme Seiten zerlegen, beschreibt das Document Chunking. Ein Abschnitt, der eine Frage in seinem ersten Satz beantwortet, hat bessere Chancen auf einen vorderen Platz als einer, der die Antwort hinter Einleitungen versteckt.
Keyword-Wiederholungen helfen dabei nicht. Relevanz entsteht aus Inhalt, und Re-Ranker erkennen, ob ein Abschnitt die Frage wirklich löst.
Wo stößt Retrieval-Evaluation an Grenzen?
Retrieval-Evaluation stößt an Grenzen, wenn Relevanzurteile fehlen, Juroren uneinig sind oder Systeme auf einen Benchmark statt auf echte Anfragen optimiert werden. Jede Metrik ist nur so verlässlich wie die Testkollektion, auf der sie beruht.
Relevanzurteile bleiben unvollständig
Relevanzurteile bleiben in großen Korpora unvollständig. Pooling beurteilt nur die Dokumente, die die beteiligten Systeme gefunden haben. Relevante Dokumente außerhalb des Pools bleiben unbekannt und gelten als irrelevant.
Das verzerrt den Recall. Die Zahl aller relevanten Dokumente wird zu niedrig angesetzt, der gemessene Recall fällt deshalb zu hoch aus.
Neue Systeme trifft das besonders. Findet ein neuartiges Verfahren relevante Dokumente, die im alten Pool fehlen, werden sie als Fehltreffer gezählt. Das neue System erscheint schlechter, als es ist.
| Grenze | Folge | Gegenmittel |
|---|---|---|
| Unvollständige Relevanzurteile | Recall wird überschätzt, neue Systeme benachteiligt | größere Pools, Nachbeurteilung neuer Treffer |
| Uneinigkeit zwischen Juroren | Ground Truth schwankt | mehrere Juroren, klare Bewertungsrichtlinien |
| Position Bias in Klicks | obere Plätze wirken relevanter | Interleaving, Korrektur über Klickmodelle |
| Überanpassung an Benchmarks | gute Benchmarkwerte, schwache Praxis | eigene Testkollektion mit realen Anfragen |
| LLMs als Juroren | systematische Verzerrungen | Stichproben durch Menschen prüfen |
LLM-Juroren beschleunigen Relevanzurteile
Große Sprachmodelle beschleunigen die Erstellung von Relevanzurteilen. Ein LLM bewertet Tausende Anfrage-Dokument-Paare in der Zeit, die ein Mensch für wenige Dutzend braucht, und das zu einem Bruchteil der Kosten.
Die Urteile sind aber nicht neutral. LLM-Juroren bevorzugen längere Texte und Formulierungen, die ihrem eigenen Stil ähneln. Bewertet ein Modell die Ausgaben eines verwandten Modells, fällt das Urteil oft zu günstig aus.
Verlässliche Testkollektionen kombinieren deshalb beide Wege. Das LLM urteilt in der Breite, Menschen prüfen eine Stichprobe und messen, wie stark die Urteile übereinstimmen.
Verwandte Themen
Retrieval-Evaluation ist das Messinstrument für jede Stufe einer Suche. Während Verfahren wie Candidate Generation, Ranking und Re-Ranking die Ergebnisliste erzeugen, entscheidet die Evaluation, ob eine Änderung sie verbessert.
Wichtige verwandte Themen sind:
- Ranking in Suchsystemen
- Re-Ranking
- Candidate Generation
- Query Expansion
- Retrieval Pipeline
- Cosine Similarity und Vektorraummodell
- BM25
- Learning to Rank
FAQ zur Retrieval-Evaluation
Was ist ein guter nDCG-Wert?
Ein guter nDCG-Wert ist nur im Vergleich mit einem anderen System auf derselben Testkollektion bestimmbar. nDCG hängt von Anfragen, Relevanzskala und Cut-off ab, deshalb sind Werte aus verschiedenen Testkollektionen nicht vergleichbar. Aussagekräftig ist allein der Abstand zwischen zwei Systemen über dieselben Anfragen.
Worin unterscheiden sich MAP und MRR?
MAP bewertet die Positionen aller relevanten Treffer, MRR nur die Position des ersten. MAP eignet sich für Anfragen, bei denen Nutzer mehrere relevante Dokumente brauchen. MRR eignet sich für Anfragen mit genau einer richtigen Antwort, bei denen jeder weitere Treffer keinen Zusatznutzen bringt.
Wie misst man Recall, wenn nicht alle relevanten Dokumente bekannt sind?
Recall ohne vollständige Relevanzurteile wird über eine Schätzung der Gesamtzahl relevanter Dokumente gemessen. Juroren beurteilen dafür eine Zufallsstichprobe aus den nicht gefundenen Dokumenten und rechnen den Anteil relevanter Dokumente auf den ganzen Korpus hoch. Alternativ misst der relative Recall, welchen Anteil der relevanten Dokumente aus dem gemeinsamen Pool aller Systeme ein einzelnes System findet.
Kann man Retrieval-Qualität mit Klickdaten messen?
Klickdaten messen Retrieval-Qualität, wenn ein Klickmodell den Position Bias herausrechnet. Klickmodelle schätzen für jeden Rang die Wahrscheinlichkeit, dass Nutzer einen Treffer überhaupt ansehen, und trennen so Aufmerksamkeit von Relevanz. Klickbasierte Messungen setzen ein laufendes System mit genügend Nutzern voraus und ergänzen die Offline-Evaluation, statt sie zu ersetzen.
Zentrale Erkenntnisse von Ralf Dodler zur Retrieval-Evaluation
„Eine Retrieval-Metrik ist nur so ehrlich wie die Relevanzurteile, auf denen sie beruht, und nur so nützlich wie die Pipeline-Stufe, zu der sie passt.“
– Ralf Dodler, Generative SEO-Stratege
- Retrieval-Evaluation misst mit Relevanzurteilen und Metriken, ob ein Suchsystem relevante Dokumente findet und weit oben platziert.
- Eine Testkollektion besteht aus Dokumentkorpus, Anfragen und Relevanzurteilen, die die Ground Truth jeder Metrik bilden.
- Precision misst die Genauigkeit einer Ergebnisliste, Recall ihre Vollständigkeit, und beide stehen im Zielkonflikt.
- Mean Reciprocal Rank bewertet nur den ersten relevanten Treffer und passt zu Anfragen mit genau einer richtigen Antwort.
- nDCG verbindet abgestufte Relevanz mit der Position und normiert das Ergebnis auf die ideale Rangfolge.
- Frühe Pipeline-Stufen optimieren Recall, Re-Ranking optimiert nDCG und MRR.
- In RAG-Systemen entscheidet der Kontext-Recall, welche Informationen das Sprachmodell überhaupt verwenden und zitieren kann.
- Unvollständige Relevanzurteile lassen den gemessenen Recall zu hoch ausfallen und benachteiligen neue Systeme.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).