Cosine Similarity und Vektorraummodell: Wie Suchsysteme Ähnlichkeit messen
Ein Suchsystem bekommt die Anfrage „Vektorsuche erklärt“ und hat Millionen Dokumente zur Auswahl. Es muss entscheiden, welches davon der Anfrage am nächsten kommt, und dafür braucht es eine Zahl, die Ähnlichkeit ausdrückt.
Cosine Similarity liefert diese Zahl. Zusammen mit dem Vektorraummodell, das Texte in Vektoren übersetzt, bildet sie die Rechengrundlage für TF-IDF-Rankings, semantische Suche und das Retrieval in AI-Search-Systemen.
Ähnlichkeitsmaße gehören zum größeren Feld des Information Retrieval, das untersucht, wie Suchsysteme relevante Informationen finden, bewerten und bereitstellen.
In diesem Artikel erfährst du, wie das Vektorraummodell Texte darstellt, wie Cosine Similarity, Skalarprodukt und euklidische Distanz rechnen und welches Maß Suchsysteme wann einsetzen.
Was ist das Vektorraummodell?
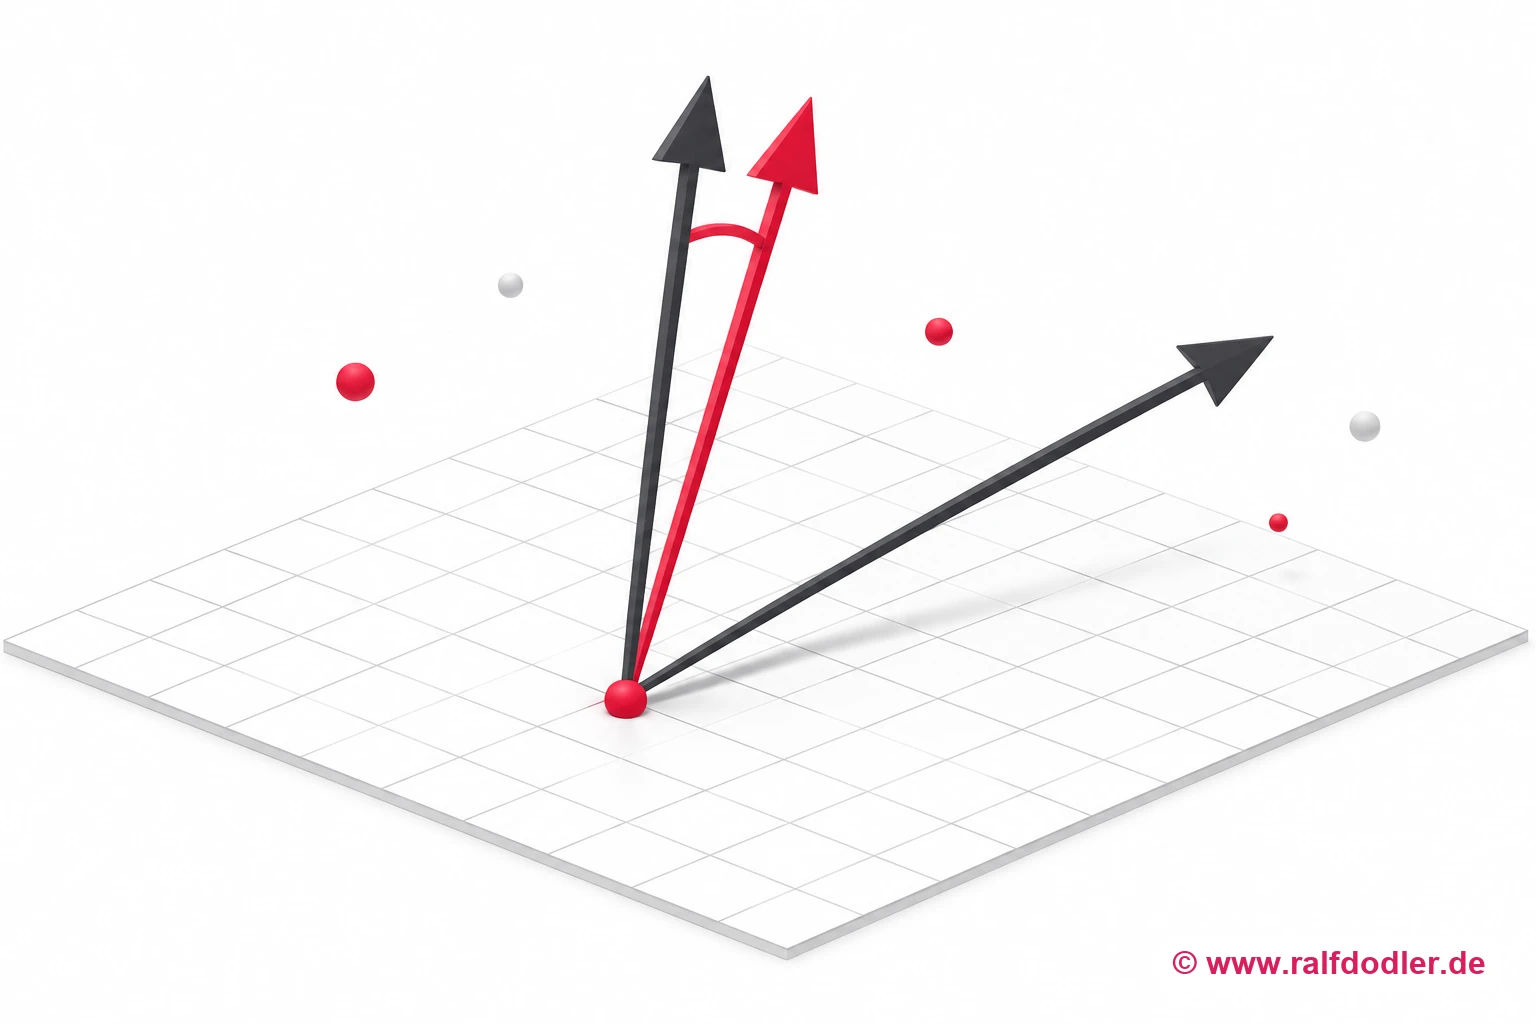
Das Vektorraummodell ist ein Retrieval-Modell, das Dokumente und Suchanfragen als Vektoren in einem gemeinsamen Raum darstellt. Die Ähnlichkeit zwischen Anfrage und Dokument entspricht ihrer geometrischen Nähe in diesem Raum und wird über ein Ähnlichkeitsmaß wie die Cosine Similarity berechnet.
Gerard Salton entwickelte das Modell in den 1960er- und 1970er-Jahren mit dem SMART-System an der Cornell University. Es löste ein Problem des Booleschen Modells: Dort erfüllt ein Dokument eine Anfrage oder nicht. Das Vektorraummodell vergibt dagegen abgestufte Werte und kann Dokumente nach Ähnlichkeit sortieren. Einen Überblick über die Modellfamilien gibt der Beitrag zu Retrieval Models.
Das Prinzip trägt bis heute. Klassische Systeme bilden Vektoren aus Termgewichten, neuronale Systeme aus Embeddings. Die Frage, wie nah sich zwei Vektoren sind, beantworten beide mit denselben Ähnlichkeitsmaßen. Damit ist das Vektorraummodell ein Grundbaustein des Information Retrieval.
Wie werden Texte zu Vektoren?
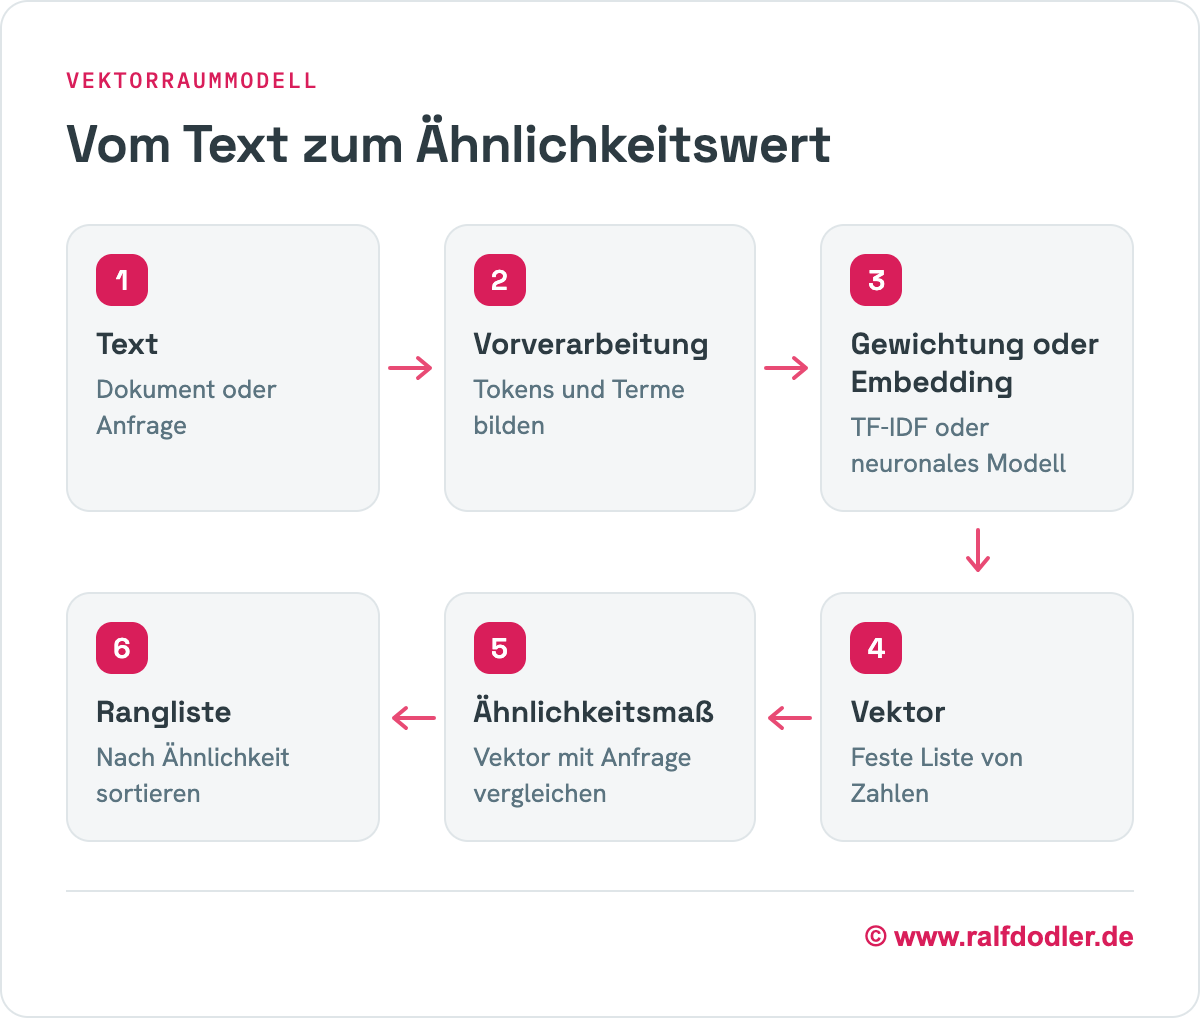
Texte werden zu Vektoren, indem ein System jedem Text eine feste Liste von Zahlen zuordnet. Klassische Verfahren leiten diese Zahlen aus den Wörtern ab, neuronale Verfahren aus einem trainierten Modell.
Terme bilden Vektordimensionen
Im klassischen Vektorraummodell steht jede Dimension für einen Term des Vokabulars. Ein Dokument ist ein Vektor, dessen Werte angeben, wie stark jeder Term darin vorkommt.
Dieses Prinzip heißt Bag of Words: Das Modell zählt Wörter und ignoriert ihre Reihenfolge. Alle Dokumentvektoren zusammen ergeben die Term-Dokument-Matrix, mit einer Zeile je Term und einer Spalte je Dokument.
Welche Terme entstehen, legt die Textvorverarbeitung fest. Sie führt Wortformen wie „Vektoren“ und „Vektor“ auf denselben Term zurück. Ohne diesen Schritt würde jede Wortform eine eigene Dimension belegen, und verwandte Dokumente lägen weiter auseinander.
TF-IDF gewichtet Vektorkomponenten
TF-IDF gewichtet jede Vektorkomponente nach der Häufigkeit des Terms im Dokument und seiner Seltenheit im gesamten Korpus. Seltene, aber im Dokument häufige Terme erhalten hohe Werte.
Ohne Gewichtung würden Allerweltswörter die Vektoren dominieren. TF-IDF senkt ihren Einfluss und hebt die Begriffe hervor, die ein Dokument von anderen unterscheidet.
Die so entstehenden Vektoren sind dünn besetzt. Ein Vokabular umfasst oft Hunderttausende Terme, ein einzelnes Dokument enthält nur wenige davon. Fast alle Werte sind 0. Darauf baut das Sparse Retrieval auf, das nur die Terme vergleicht, die Anfrage und Dokument gemeinsam haben.
| Term | Anfrage | Dokument A | Dokument B |
|---|---|---|---|
| vektor | 1 | 2 | 0 |
| ähnlichkeit | 1 | 1 | 1 |
| ranking | 0 | 0 | 3 |
Embeddings verdichten Bedeutung
Embeddings verdichten die Bedeutung eines Textes in einen dichten Vektor mit einigen hundert bis einigen tausend Dimensionen. Ein neuronales Modell erzeugt diese Werte, nachdem es an großen Textmengen gelernt hat, welche Texte inhaltlich zusammengehören.
Die einzelnen Dimensionen stehen nicht mehr für Wörter. Sie tragen gemeinsam Bedeutung. Texte mit ähnlichem Inhalt landen nah beieinander, auch wenn sie keine Wörter teilen.
Auf diesem Prinzip beruht Dense Retrieval. Am Vergleich ändert sich nichts: Auch dichte Vektoren werden über Ähnlichkeitsmaße wie die Cosine Similarity verglichen.
Was ist Cosine Similarity?
Cosine Similarity ist ein Ähnlichkeitsmaß, das den Kosinus des Winkels zwischen zwei Vektoren berechnet. Zeigen zwei Vektoren in dieselbe Richtung, ist der Wert 1. Sie ist das Standardmaß der Similarity Search, also der Suche nach den ähnlichsten Vektoren.
Cosine Similarity misst Winkel
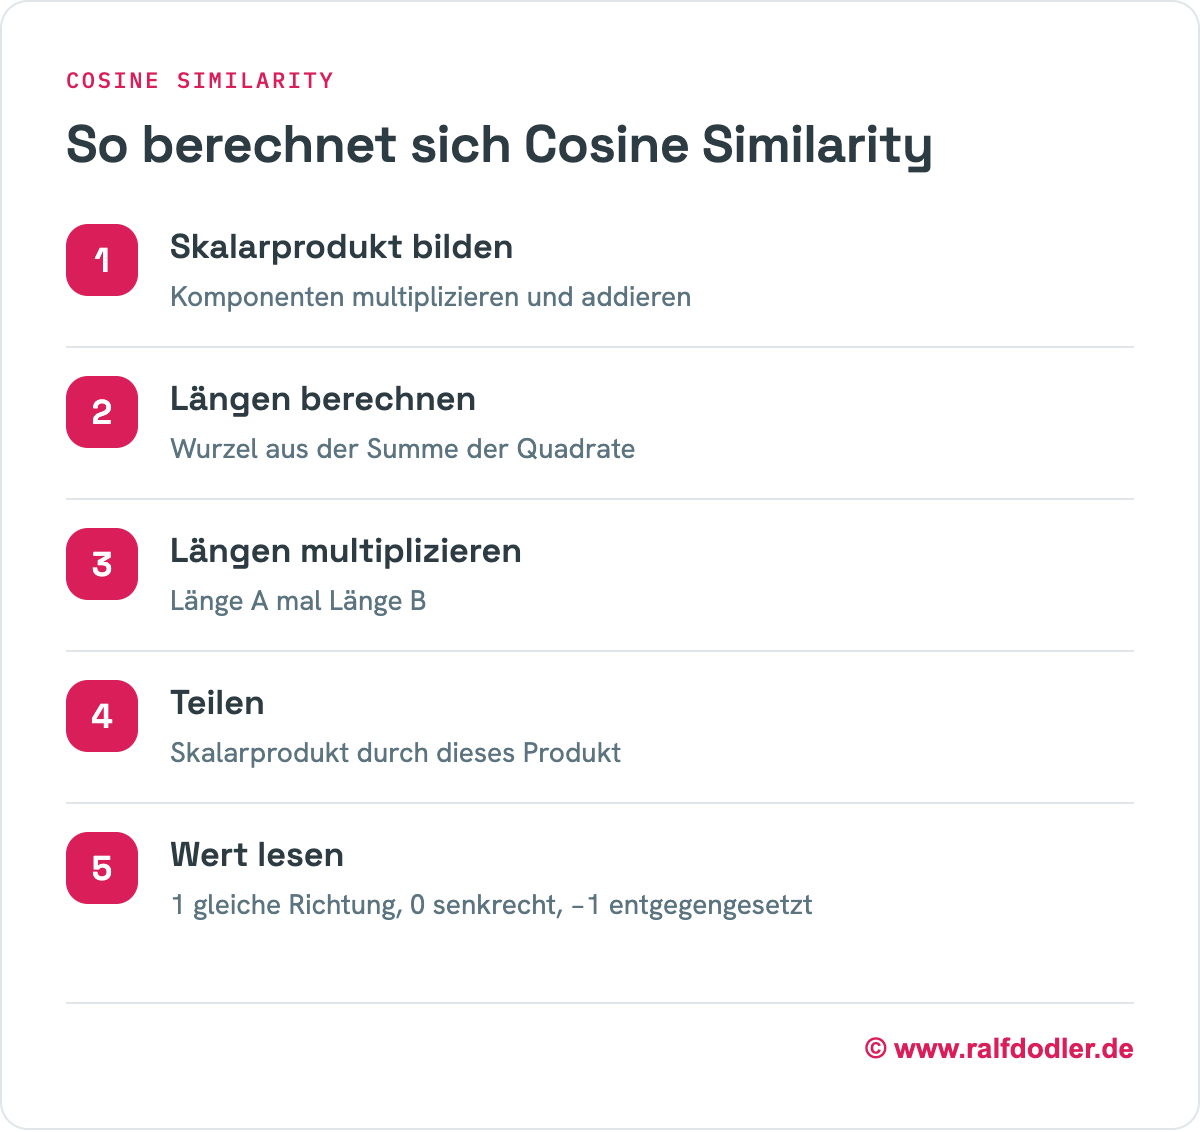
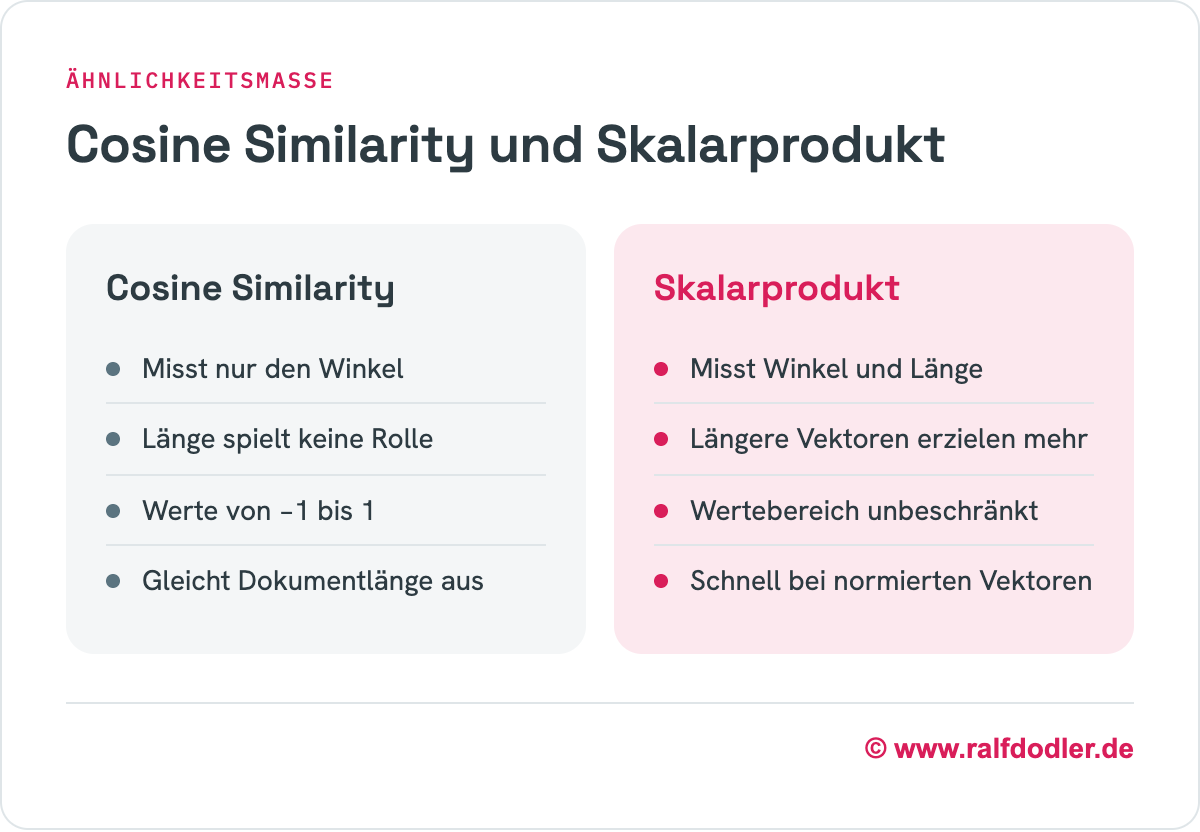
Cosine Similarity misst den Winkel zwischen zwei Vektoren und ignoriert ihre Länge. Berechnet wird sie als Skalarprodukt der beiden Vektoren, geteilt durch das Produkt ihrer Längen.
Der Wert liegt zwischen −1 und 1. Bei 1 zeigen beide Vektoren in dieselbe Richtung, bei 0 stehen sie senkrecht zueinander, bei −1 zeigen sie in entgegengesetzte Richtungen. Je kleiner der Winkel, desto ähnlicher die Texte.
TF-IDF-Vektoren enthalten keine negativen Werte. Ihre Cosine Similarity liegt deshalb immer zwischen 0 und 1. Embeddings können negative Komponenten haben und damit den vollen Wertebereich nutzen.
Normierung neutralisiert Dokumentlänge
Die Division durch die Vektorlängen neutralisiert die Dokumentlänge. Ein Dokument, das doppelt so lang ist, aber dieselben Terme im selben Verhältnis enthält, erhält denselben Wert.
Das ist im Retrieval wichtig. Lange Dokumente enthalten mehr Terme und erzielen schon deshalb höhere Rohwerte. Ohne Normierung würden sie kurze, präzise Dokumente verdrängen, nur weil sie mehr Text haben.
Das Rechenbeispiel mit den Werten aus der Term-Dokument-Matrix zeigt den Effekt. Dokument A′ ist Dokument A in doppelter Länge, mit denselben Termen im selben Verhältnis. Das Skalarprodukt verdoppelt sich, die Cosine Similarity bleibt gleich.
| Vergleich | Skalarprodukt | Länge Dokument | Cosine Similarity |
|---|---|---|---|
| Anfrage und Dokument A (2, 1, 0) | 3 | 2,24 | 0,95 |
| Anfrage und Dokument A′ (4, 2, 0) | 6 | 4,47 | 0,95 |
| Anfrage und Dokument B (0, 1, 3) | 1 | 3,16 | 0,22 |
Was ist das Skalarprodukt?
Das Skalarprodukt, englisch Dot Product, ist die Summe der Produkte aller Vektorkomponenten. Es ist das einfachste Ähnlichkeitsmaß im Vektorraum und zugleich der Kern der Cosine Similarity.
Skalarprodukt verbindet Richtung und Länge
Das Skalarprodukt verbindet Richtung und Länge zweier Vektoren in einem Wert. Zeigen sie in ähnliche Richtungen, wird es groß. Sind sie lang, wird es noch größer.
Im Rechenbeispiel liefert die Anfrage mit Dokument A den Wert 3, mit Dokument A′ den Wert 6. Inhaltlich sind beide Dokumente gleich, das Skalarprodukt bevorzugt trotzdem das längere.
Der Wertebereich ist nach oben offen. Ein einzelner Wert sagt deshalb wenig, nur die Rangfolge zählt. Manche Embedding-Modelle nutzen die Länge bewusst, etwa als Signal dafür, wie informativ ein Text ist. Dann ist das Skalarprodukt das passende Maß.
Normierte Vektoren vereinheitlichen Maße
Normierte Vektoren vereinheitlichen Skalarprodukt und Cosine Similarity. Hat jeder Vektor die Länge 1, ist das Skalarprodukt genau die Cosine Similarity, weil die Division durch die Längen entfällt.
Viele Embedding-Modelle liefern ihre Vektoren bereits normiert. Suchsysteme rechnen dann das Skalarprodukt, weil es schneller ist, und erhalten trotzdem die Rangfolge der Cosine Similarity.
Für diese Suche nach dem größten Skalarprodukt gibt es einen eigenen Begriff: Maximum Inner Product Search. Vektordatenbanken und Suchbibliotheken bieten sie als eigene Metrik an.
Was misst die euklidische Distanz?
Die euklidische Distanz misst den geraden Abstand zwischen den Spitzen zweier Vektoren. Anders als die beiden anderen Maße drückt sie Unterschied aus: Je kleiner die Distanz, desto ähnlicher die Texte.
Euklidische Distanz misst Abstand
Die euklidische Distanz misst den Abstand zweier Punkte im Raum, so wie ein Lineal auf Papier. Sie ist die Wurzel aus der Summe der quadrierten Differenzen aller Komponenten.
Anders als die Cosine Similarity reagiert sie auf die Länge der Vektoren. Im Rechenbeispiel liegt Dokument A im Abstand 1 zur Anfrage. Dokument A′, inhaltlich identisch, liegt im Abstand 3,16, genauso weit entfernt wie das fremde Dokument B.
Für Texte unterschiedlicher Länge ist die euklidische Distanz auf Rohvektoren deshalb ungeeignet. Sie verwechselt Länge mit Bedeutung.
Normierung koppelt Distanz und Kosinus
Normierung koppelt die euklidische Distanz an die Cosine Similarity. Bei Vektoren der Länge 1 gilt: Das Quadrat der Distanz ist 2 minus zweimal die Cosine Similarity.
Beide Maße liefern dann dieselbe Rangfolge, nur in umgekehrter Richtung. Die höchste Cosine Similarity gehört zur kleinsten Distanz.
Viele Suchbibliotheken und Vektordatenbanken bieten die euklidische Distanz an, oft als L2-Distanz bezeichnet. Mit normierten Embeddings ist diese Wahl unkritisch. Ohne Normierung hängt das Ergebnis von der Textlänge ab.
| Kriterium | Cosine Similarity | Skalarprodukt | Euklidische Distanz |
|---|---|---|---|
| Misst | Winkel | Winkel und Länge | Abstand der Vektorspitzen |
| Wertebereich | −1 bis 1 | unbeschränkt | 0 bis unendlich |
| Einfluss der Länge | keiner | stark | stark |
| Ähnlich bedeutet | hoher Wert | hoher Wert | kleiner Wert |
| Typischer Einsatz | TF-IDF, semantische Suche | normierte Embeddings, Modelle mit Längensignal | Clustering, normierte Embeddings |
Wie nutzen Suchsysteme Ähnlichkeitsmaße?
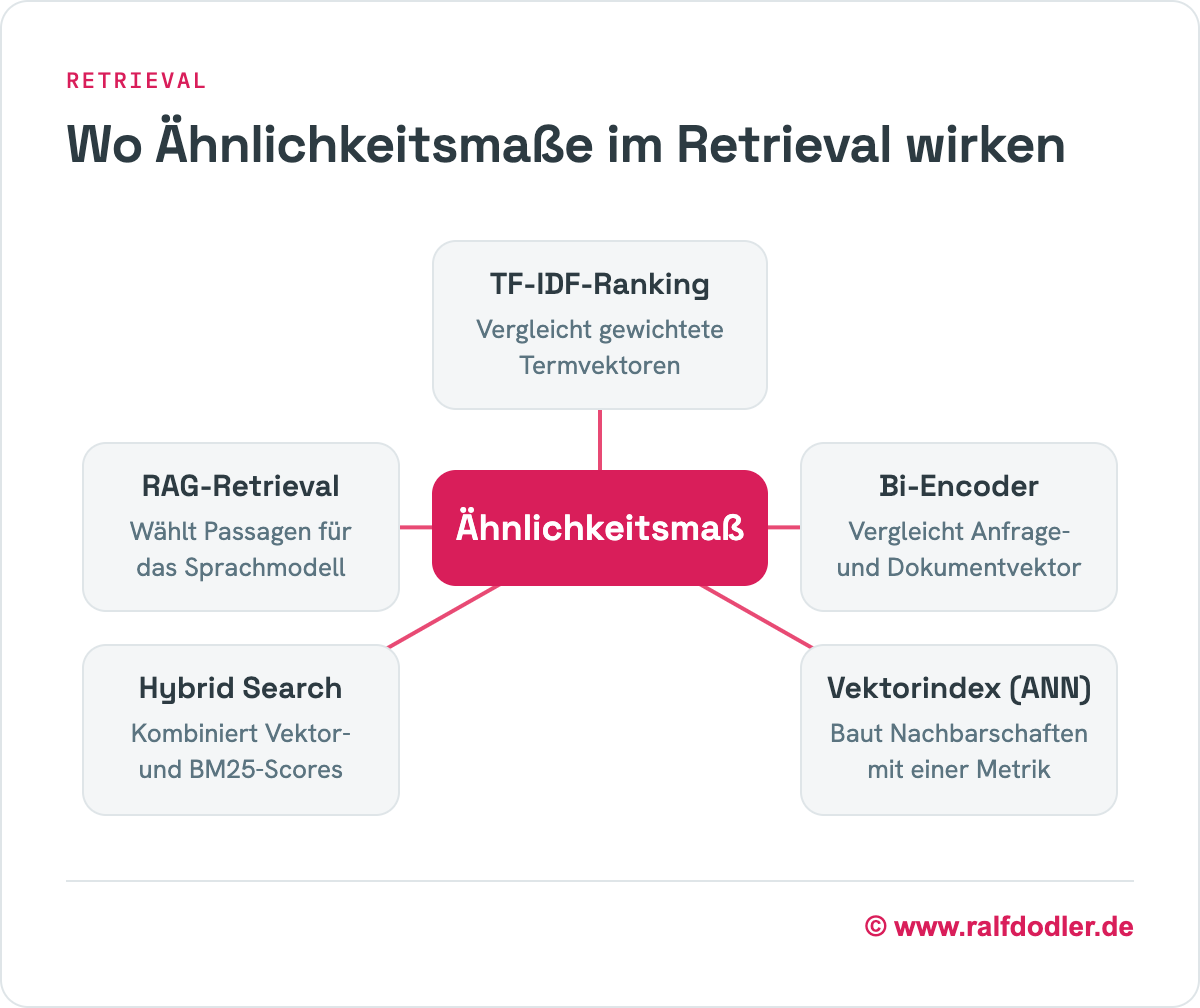
Suchsysteme nutzen Ähnlichkeitsmaße, um aus Millionen Vektoren die Kandidaten zu wählen, die einer Anfrage am nächsten sind. Nur diese Kandidaten gelangen ins Ranking oder in die Antwort eines Sprachmodells. Das Generative Authority Model (GAM) von Ralf Dodler beschreibt diese Abrufbarkeit als Retrieval Activation. Für das Vector Retrieval ist das Ähnlichkeitsmaß dabei die zentrale Rechenoperation.
Embedding-Modelle bestimmen Ähnlichkeitsmaß
Ein Embedding-Modell bestimmt, welches Ähnlichkeitsmaß zu seinen Vektoren passt. Es wird mit einem bestimmten Maß trainiert und lernt, Texte so anzuordnen, dass genau dieses Maß verwandte Inhalte erkennt.
Ein Bi-Encoder etwa kodiert Anfrage und Dokument getrennt und vergleicht sie danach über Cosine Similarity oder Skalarprodukt. Welches der beiden, steht in der Dokumentation des Modells.
Wer ein anderes Maß wählt als das Training, verschiebt die Rangfolge. Bei normierten Vektoren bleibt der Fehler folgenlos. Bei Modellen, die mit Vektorlängen arbeiten, verliert die Suche Qualität.
ANN-Indizes benötigen passende Metrik
ANN-Indizes benötigen beim Aufbau eine feste Metrik. Die Approximate Nearest Neighbor Search durchsucht große Vektormengen nicht vollständig, sondern über vorberechnete Nachbarschaften.
Diese Nachbarschaften entstehen mit einem bestimmten Ähnlichkeitsmaß. Ein Index für Cosine Similarity ordnet die Vektoren anders als einer für euklidische Distanz.
Beim Vector Indexing wird die Metrik deshalb gemeinsam mit dem Embedding-Modell festgelegt. Ein späterer Wechsel des Maßes bedeutet, den Index neu aufzubauen.
Hybrid Search kombiniert Scores
Hybrid Search kombiniert die Scores einer Vektorsuche mit denen einer lexikalischen Suche. Beide Werte liegen auf verschiedenen Skalen und lassen sich nicht direkt addieren.
Die Cosine Similarity liegt zwischen −1 und 1. BM25 liefert Werte ohne feste Obergrenze, die von Anfrage und Korpus abhängen.
Hybride Systeme gleichen das auf zwei Wegen aus. Sie normieren beide Scores auf denselben Bereich, bevor sie sie gewichten, oder sie kombinieren nur die Rangplätze, etwa mit Reciprocal Rank Fusion. Der zweite Weg ist robuster, weil er die Skalen ganz umgeht.
Wo stößt das Vektorraummodell an Grenzen?
Das Vektorraummodell stößt an Grenzen, wenn Wörter allein die Bedeutung nicht tragen oder geometrische Nähe nicht dasselbe ist wie Relevanz. Manche Grenzen betreffen nur das klassische Modell, andere auch Embeddings. Dazu kommt, dass das klassische Modell die Wortreihenfolge ignoriert: „Hund beißt Mann“ und „Mann beißt Hund“ ergeben denselben Vektor.
Termunabhängigkeit übersieht Synonyme
Das klassische Vektorraummodell behandelt jeden Term als eigene, unabhängige Dimension. „Auto“ und „PKW“ stehen dort senkrecht zueinander, ihre Ähnlichkeit ist 0.
Eine Anfrage mit „PKW“ findet deshalb kein Dokument, das nur „Auto“ sagt. Die Forschung nennt das Vocabulary Mismatch: Anfrage und Dokument meinen dasselbe, verwenden aber verschiedene Wörter.
Embeddings lösen dieses Problem weitgehend, weil sie Bedeutung statt Wortgleichheit abbilden. Dafür verlieren sie an Genauigkeit bei exakten Begriffen wie Produktnummern oder Eigennamen.
| Grenze | Folge | Gegenmittel |
|---|---|---|
| Termunabhängigkeit | Synonyme werden nicht gefunden | Embeddings, Query Expansion |
| Hohe Dimensionen | Abstände gleichen sich an | gut trainierte Embedding-Modelle |
| Ähnlichkeit ohne Relevanz | thematisch nahe, aber nutzlose Treffer | Reranking mit Cross-Encoder |
| Wortreihenfolge fehlt | „Hund beißt Mann“ gleich „Mann beißt Hund“ | Embeddings, Phrasensuche |
Hohe Dimensionen verwischen Abstände
Hohe Dimensionen verwischen die Unterschiede zwischen Abständen. In Räumen mit Hunderten Dimensionen liegen zufällige Punkte fast gleich weit voneinander entfernt.
Dieser Effekt gehört zum Fluch der Dimensionalität. Eine Folge heißt Hubness: Einzelne Vektoren tauchen als nächster Nachbar vieler anderer auf, obwohl sie inhaltlich wenig passen.
Embeddings funktionieren trotzdem, weil echte Texte nicht zufällig im Raum verteilt sind. Ein gutes Modell ordnet sie in Regionen, in denen Abstände Bedeutung tragen. Ein schwaches Modell verstärkt die Probleme.
Ähnlichkeit ersetzt keine Relevanz
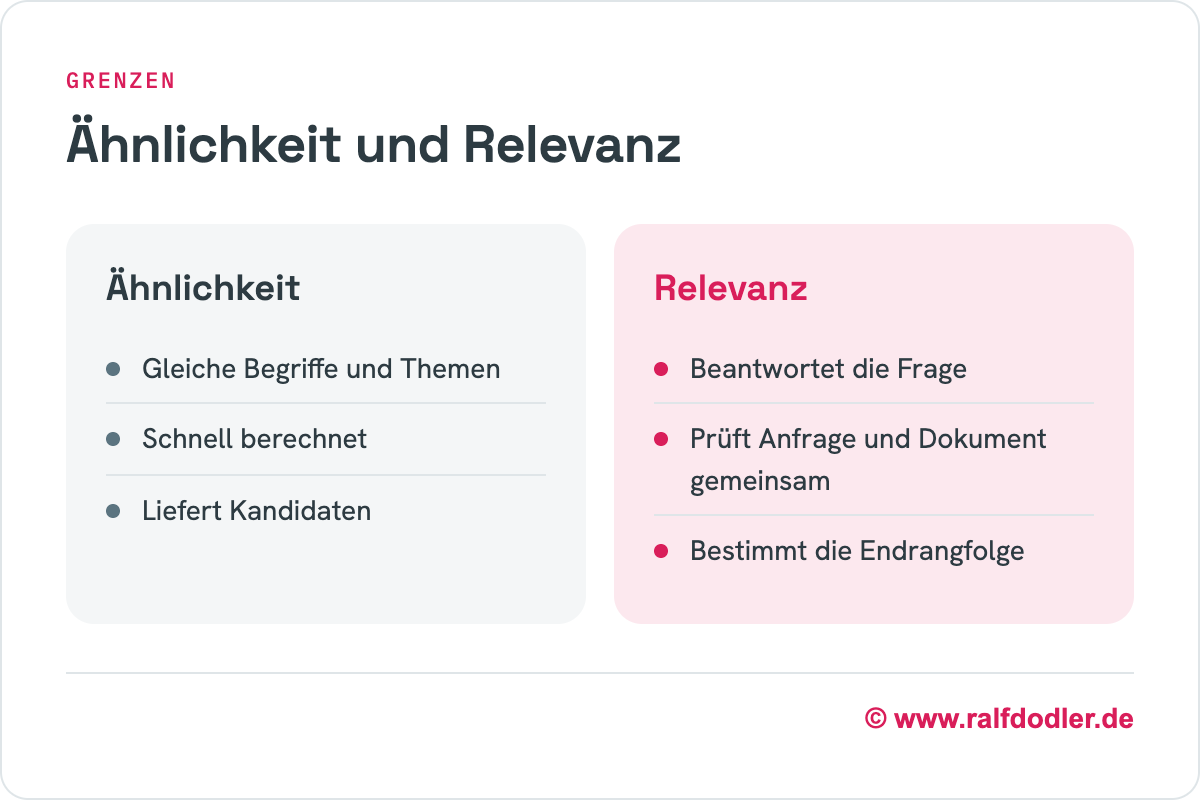
Hohe Ähnlichkeit bedeutet nicht, dass ein Dokument die Anfrage beantwortet. Ähnlichkeitsmaße messen, ob zwei Texte über dasselbe Thema sprechen, nicht, ob einer die Frage des anderen löst.
Eine Anfrage nach den Nachteilen eines Verfahrens liegt nah an einem Text über seine Vorteile. Beide teilen Begriffe und Thema, nur einer hilft.
Suchsysteme nutzen Ähnlichkeit deshalb für die schnelle Kandidatensuche und prüfen danach genauer. Ein Cross-Encoder liest Anfrage und Dokument gemeinsam und bewertet, ob das Dokument passt.
Was bedeutet Vektorähnlichkeit für Inhalte?
Vektorähnlichkeit bedeutet für Inhalte, dass ein Abschnitt nur gefunden wird, wenn sein Vektor nah an den Vektoren der passenden Anfragen liegt. Wie präzise dieser Vektor ausfällt, hängt davon ab, wie ein Text aufgebaut und formuliert ist.
Fokussierte Abschnitte erzeugen präzise Vektoren
Ein fokussierter Abschnitt erzeugt einen präzisen Vektor. AI-Search-Systeme zerlegen Seiten in Passagen und berechnen für jede einen eigenen Vektor.
Behandelt eine Passage ein Thema, liegt ihr Vektor nah an Anfragen zu diesem Thema. Mischt sie drei Themen, landet ihr Vektor irgendwo dazwischen und ist für keine Anfrage der nächste.
Wie Systeme Seiten zerlegen, beschreibt der Beitrag zum Document Chunking. Ein Abschnitt pro Frage ist die beste Voraussetzung.
Eindeutige Begriffe schärfen Embeddings
Eindeutige Begriffe schärfen das Embedding eines Textes. Ein Fachbegriff mit Definition und Kontext gibt dem Modell klare Signale, wo der Text im Bedeutungsraum hingehört.
Wiederholungen helfen dabei nicht. Ein Embedding-Modell zählt keine Wörter, es erfasst Bedeutung aus dem Zusammenhang.
Wer Begriffe einführt, definiert und in Beziehung zu verwandten Konzepten setzt, erzeugt einen eindeutigen Vektor. Diesen Ansatz verfolgt die Semantische Optimierung.
Verwandte Themen
Das Vektorraummodell und seine Ähnlichkeitsmaße verbinden klassische und neuronale Suche. Während Gewichtungsverfahren und Embedding-Modelle die Vektoren erzeugen, entscheidet das Ähnlichkeitsmaß, welche davon zur Anfrage passen.
Wichtige verwandte Themen sind:
- Embeddings
- Vector Retrieval
- Bi-Encoder
- TF-IDF
- Textvorverarbeitung
- Approximate Nearest Neighbor Search
- Hybrid Search
- Retrieval-Evaluation mit Precision, Recall und nDCG
FAQ zur Cosine Similarity
Welcher Cosine-Wert gilt als ähnlich?
Einen festen Cosine-Wert, ab dem Texte als ähnlich gelten, gibt es nicht. Der Wert hängt vom Embedding-Modell ab, weil jedes Modell seine Vektoren anders im Raum verteilt. Bei manchen Modellen liegen schon unverwandte Texte bei 0,5, bei anderen bei 0,1. Schwellenwerte werden deshalb je Modell an Beispielen festgelegt, oft zählt nur die Rangfolge.
Kann Cosine Similarity negativ sein?
Cosine Similarity kann negativ sein, wenn Vektoren negative Komponenten enthalten. Bei TF-IDF-Vektoren kommt das nicht vor, ihre Werte liegen zwischen 0 und 1. Bei Embeddings sind negative Werte möglich, in der Praxis aber selten, weil viele Modelle Texte in einem engen Bereich des Raums anordnen.
Nutzen Sprachmodelle Cosine Similarity?
Sprachmodelle nutzen Cosine Similarity vor allem im Retrieval, nicht in der Textgenerierung. Bei Retrieval-Augmented Generation wählt ein Ähnlichkeitsmaß die Passagen aus, die das Modell als Kontext erhält. Im Modell selbst vergleicht der Attention-Mechanismus Vektoren über skalierte Skalarprodukte.
Worin unterscheidet sich Cosine Similarity von semantischer Ähnlichkeit?
Cosine Similarity ist ein Rechenverfahren, semantische Ähnlichkeit eine inhaltliche Eigenschaft von Texten. Cosine Similarity misst nur den Winkel zwischen zwei Vektoren. Ob dieser Winkel Bedeutung abbildet, hängt davon ab, wie die Vektoren entstanden sind. Erst Embeddings machen die Cosine Similarity zum Maß für semantische Ähnlichkeit, wie sie die semantische Suche nutzt.
Zentrale Erkenntnisse von Ralf Dodler zur Cosine Similarity
„Cosine Similarity misst, ob zwei Texte in dieselbe Richtung zeigen, nicht, ob einer die Frage des anderen beantwortet.“
– Ralf Dodler, Generative SEO-Stratege
- Das Vektorraummodell stellt Dokumente und Anfragen als Vektoren in einem gemeinsamen Raum dar und misst Ähnlichkeit als geometrische Nähe.
- Klassische Systeme bilden Vektoren aus TF-IDF-Gewichten, neuronale Systeme aus Embeddings, verglichen werden beide mit denselben Ähnlichkeitsmaßen.
- Cosine Similarity misst den Winkel zwischen zwei Vektoren und gleicht dadurch Unterschiede in der Dokumentlänge aus.
- Das Skalarprodukt verbindet Richtung und Länge und entspricht bei normierten Vektoren genau der Cosine Similarity.
- Die euklidische Distanz reagiert auf Vektorlängen und liefert erst bei normierten Vektoren dieselbe Rangfolge wie die Cosine Similarity.
- Ein Embedding-Modell legt durch sein Training fest, welches Ähnlichkeitsmaß zu seinen Vektoren passt, und der Vektorindex muss dieselbe Metrik nutzen.
- Hohe Ähnlichkeit liefert Kandidaten, erst ein Reranking prüft, ob ein Dokument die Anfrage tatsächlich beantwortet.
- Fokussierte Abschnitte mit eindeutigen Begriffen erzeugen präzise Vektoren und werden dadurch für passende Anfragen abrufbar.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).