Alte Blogartikel mit KI überarbeiten: Ich gebe nur noch frei
Auf fast jedem Blog liegen Artikel, die irgendwann gut waren. Manche sind noch mit einem alten Page Builder gebaut, manche zitieren Zahlen von vorgestern, und kaum einer sagt Suchmaschinen und KI-Systemen sauber, worum es eigentlich geht.
Auf ralfdodler.de war das nicht anders. Seit Ende Oktober überarbeitet meine Content-Machine solche Artikel. Ich gebe nur noch zweimal frei: die Gliederung und am Ende den Tausch des Inhalts.
Am 26. und 27. Oktober sind so fünf Artikel neu gefasst worden. Hier sind die Aufgabe, der Ablauf, das Ergebnis und die Grenzen.
Warum sich die Pflege alter Artikel lohnt
Alte Artikel zu überarbeiten ist kein Selbstzweck. Google fragt in seinen Leitlinien zu hilfreichen Inhalten ausdrücklich, ob man das Datum einer Seite ändert, damit sie frisch wirkt, obwohl sich der Inhalt kaum geändert hat. Ein neues Datum allein ist also keine Pflege, sondern ein Warnsignal.
Dazu kommt die KI-Suche. Ahrefs hat 17 Millionen Zitate aus KI-Assistenten ausgewertet und mit den klassischen Google-Treffern verglichen. Ergebnis: Die zitierten Seiten sind im Schnitt 25,7 % frischer. ChatGPT bevorzugt neue Inhalte am deutlichsten, die AI Overviews von Google zitieren etwas ältere Seiten. Ein veralteter Artikel verliert also doppelt, im Ranking und als Quelle für Antworten.
Die Aufgabe für die Maschine lautet deshalb nicht „Datum hochsetzen“, sondern: Artikel inhaltlich auf den aktuellen Stand bringen, die Struktur schärfen, Entitäten klar auszeichnen und Medien sauber einbinden.
Der Ablauf: fünf Schritte, zwei Freigaben
Jeder Durchgang folgt demselben Muster. Die KI erledigt die Fleißarbeit, die Entscheidungen bleiben bei mir.
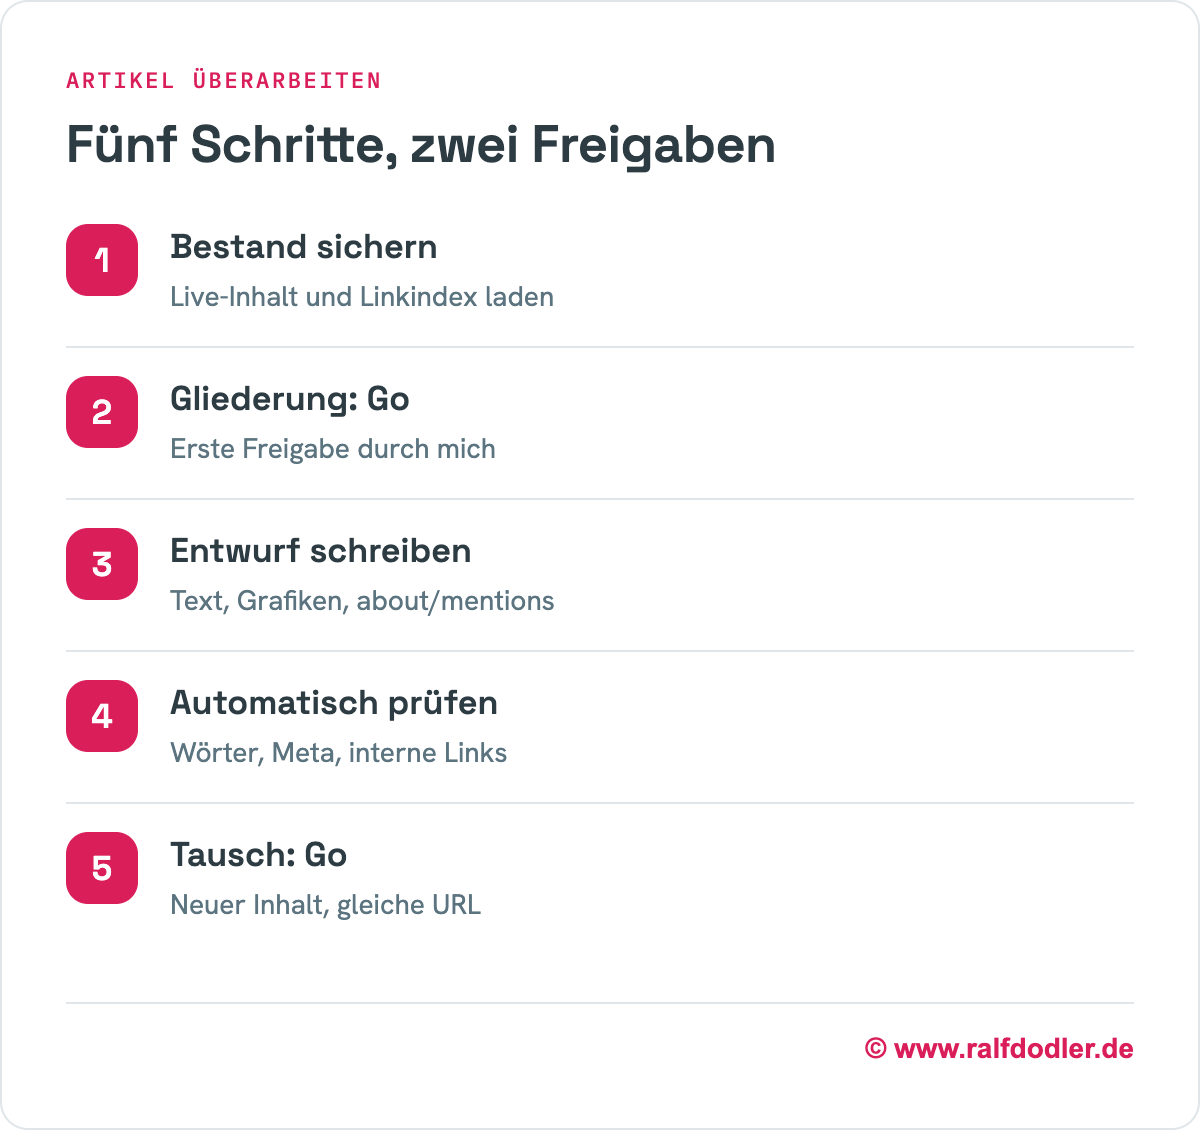
- Bestand sichern. Im Dashboard klicke ich bei einem Artikel auf „Überarbeiten“. Das Tool sichert den Live-Inhalt samt Änderungsstand und lädt einen Linkindex aller Beiträge über die WordPress-REST-API. So weiß die KI, worauf sie intern verlinken kann.
- Gliederung vorschlagen. Die KI analysiert, was am Bestand trägt und was fehlt, und baut eine neue Gliederung nach meinem Fachbeitrags-Framework. Darin stehen auch die geplanten Grafiken, Linkziele und FAQ. Hier gebe ich zum ersten Mal frei.
- Entwurf schreiben. Neuer Text, Grafiken, Tabellen, interne Links und die strukturierten Daten
aboutundmentions. Der Entwurf landet in WordPress als Entwurf unter einem Bot-Konto. - Automatisch prüfen. Ein Prüftool zählt Wörter, Grafiken, Meta-Längen und Tabellen und gleicht jeden internen Link mit dem Linkindex ab. Fehler sehe ich, bevor ich den Entwurf lese.
- Inhalt tauschen. Der neue Inhalt ersetzt den alten unter derselben URL. Das ist die zweite Freigabe, eine pro Artikel. Wurde der Live-Artikel seit dem Sichern geändert, bricht der Tausch ab, damit nichts überschrieben wird.
Warum about und mentions ein eigener Schritt sind
Schema.org kennt für Artikel zwei Eigenschaften, die oft untergehen: about beschreibt das Thema, um das es im Kern geht. mentions steht für Begriffe, Tools oder Organisationen, die der Text nur erwähnt, ohne dass sie das Thema sind. Für Entity SEO ist genau diese Trennung wertvoll, weil sie Maschinen sagt, welche Entität im Mittelpunkt steht.
Wichtig ist die Einordnung. Google sagt klar, dass es für AI Overviews und den AI Mode kein spezielles Schema-Markup braucht. Und strukturierte Daten müssen den Inhalt der Seite wahrheitsgemäß abbilden. Markup ist bei mir deshalb Klarstellung, kein Trick: Die KI schlägt die Werte passend zum neuen Text vor, ich gebe sie zusammen mit dem Inhalt frei.
Zum festen Schritt wurde das aus einem praktischen Grund. Der Tausch löst die Automatik, die sonst beim Veröffentlichen about und mentions setzt, nicht aus. Ohne eigenen Schritt blieben die alten Werte stehen, auch wenn der Text ein ganz anderer ist. Fehlen die Werte, meldet das Prüftool einen Fehler.
Was es gebracht hat
Am 26. und 27. Oktober sind fünf Artikel neu gefasst worden: n-Gramm, semantische Optimierung, Grounding in der KI, Prompt Engineering für Einsteiger und Entity SEO. Vier davon sind dabei gleichzeitig vom alten Page Builder in den normalen WordPress-Editor gewandert.
Beim Artikel zu Entity SEO kamen ein neues Beitragsbild und zwölf mentions dazu. Meine Arbeit war: eine Gliederung lesen, einen Entwurf lesen, zweimal Go sagen.
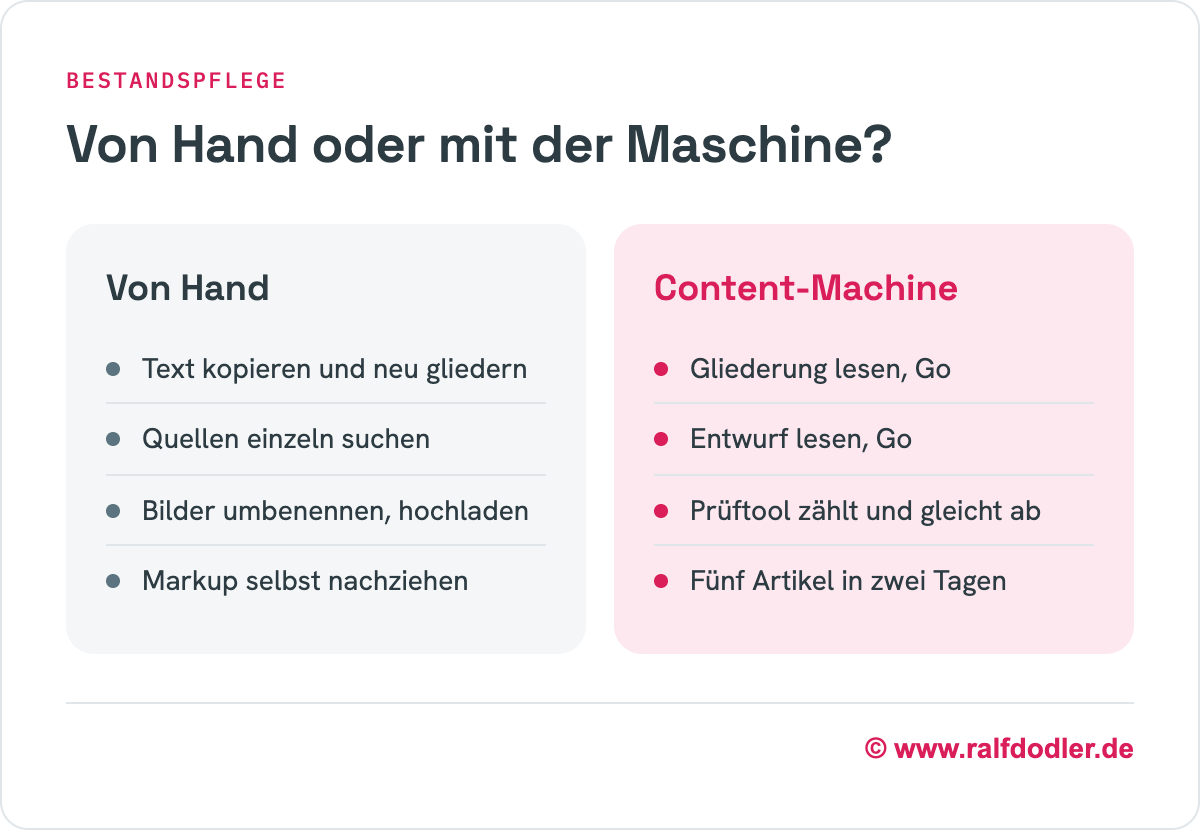
Der größere Gewinn ist aber nicht die Zeit pro Artikel. Es ist, dass die Pflege überhaupt stattfindet. Bestandsartikel standen immer hinter neuen Artikeln zurück. Jetzt ist ihre Überarbeitung ein Auftrag mit zwei Momenten Aufmerksamkeit.
Die Grenzen: was ich nicht abgebe
Drei Dinge gebe ich bewusst nicht aus der Hand:
- Die Gliederung. Sie entscheidet, welche Frage der Artikel beantwortet. Ist sie falsch, hilft der beste Text nichts.
- Fakten und Zahlen. Die KI findet Quellen, aber auch schwache. Jede Zahl braucht eine Quelle mit Datum, und die prüfe ich.
- Der Tausch. Der Entwurf läuft unter einem Bot-Konto, live geht er erst mit meinem Go. Nichts ersetzt automatisch einen veröffentlichten Artikel.
Ein Lerneffekt aus der Praxis: Beim Tausch von Entity SEO landeten die Bilder mit dem Namen des Entwurfs in der Mediathek, inklusive des Arbeitsworts „neufassung“. Aus SEO-Sicht sinnlos. Seitdem nimmt das Tool bei Überarbeitungen den Slug des Live-Artikels. Solche Fehler fallen nur auf, wenn man das Ergebnis wirklich anschaut.
Wer seinen Bestand ebenfalls auffrischen will, sollte nicht mit dem Text anfangen, sondern mit der Frage, welche Entscheidungen er selbst behalten will. Den Rest kann die Maschine.
Quellen
- Google Search Central: Hilfreiche, zuverlässige Inhalte erstellen
- Google Search Central: KI-Funktionen und deine Website
- Google Search Central: Allgemeine Richtlinien für strukturierte Daten
- Schema.org: about
- Schema.org: mentions
- Ahrefs (22.12.2025): Fresh Content – Why Publish Dates Make or Break Rankings and AI Visibility

Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).