Textvorverarbeitung: Wie Suchsysteme Texte für das Retrieval aufbereiten
Ein Nutzer sucht nach „Häuser renovieren“, das passende Dokument spricht von einem „renovierten Haus“. Für einen Computer sind das zunächst vier verschiedene Zeichenketten, und der Abgleich scheitert an den Wortformen.
Textvorverarbeitung löst dieses Problem, bevor ein Suchsystem überhaupt Relevanz berechnet. Sie bestimmt, welche Begriffe im Index landen und welche Wortformen eine Anfrage dort wiederfindet. Das gilt für klassische Suchmaschinen ebenso wie für AI-Search-Systeme, die Passagen für Sprachmodelle abrufen.
Textvorverarbeitung gehört zum größeren Feld des Information Retrieval, das untersucht, wie Suchsysteme relevante Informationen finden, bewerten und bereitstellen.
In diesem Artikel erfährst du, welche Schritte die Textvorverarbeitung umfasst, wie sich Stemming und Lemmatisierung unterscheiden und wie die Aufbereitung Recall und Precision einer Suche prägt.
Was ist Textvorverarbeitung?
Textvorverarbeitung ist die Verarbeitungskette aus Bereinigung, Tokenisierung, Normalisierung und Wortformreduktion (Stemming oder Lemmatisierung), die Suchsysteme vor der Indexierung auf Texte anwenden. Textvorverarbeitung überführt Rohtext in einheitliche Indexterme, damit Anfrage und Dokument über dieselben Begriffe vergleichbar werden.
Im Information Retrieval bildet die Textvorverarbeitung die erste Stufe jeder lexikalischen Suche. Erst danach entstehen Indexstrukturen, Gewichte und Rankings. Die Indexierung speichert genau die Terme, die die Vorverarbeitung erzeugt hat. Was diese Stufe verwirft oder falsch zerlegt, findet keine spätere Stufe wieder.
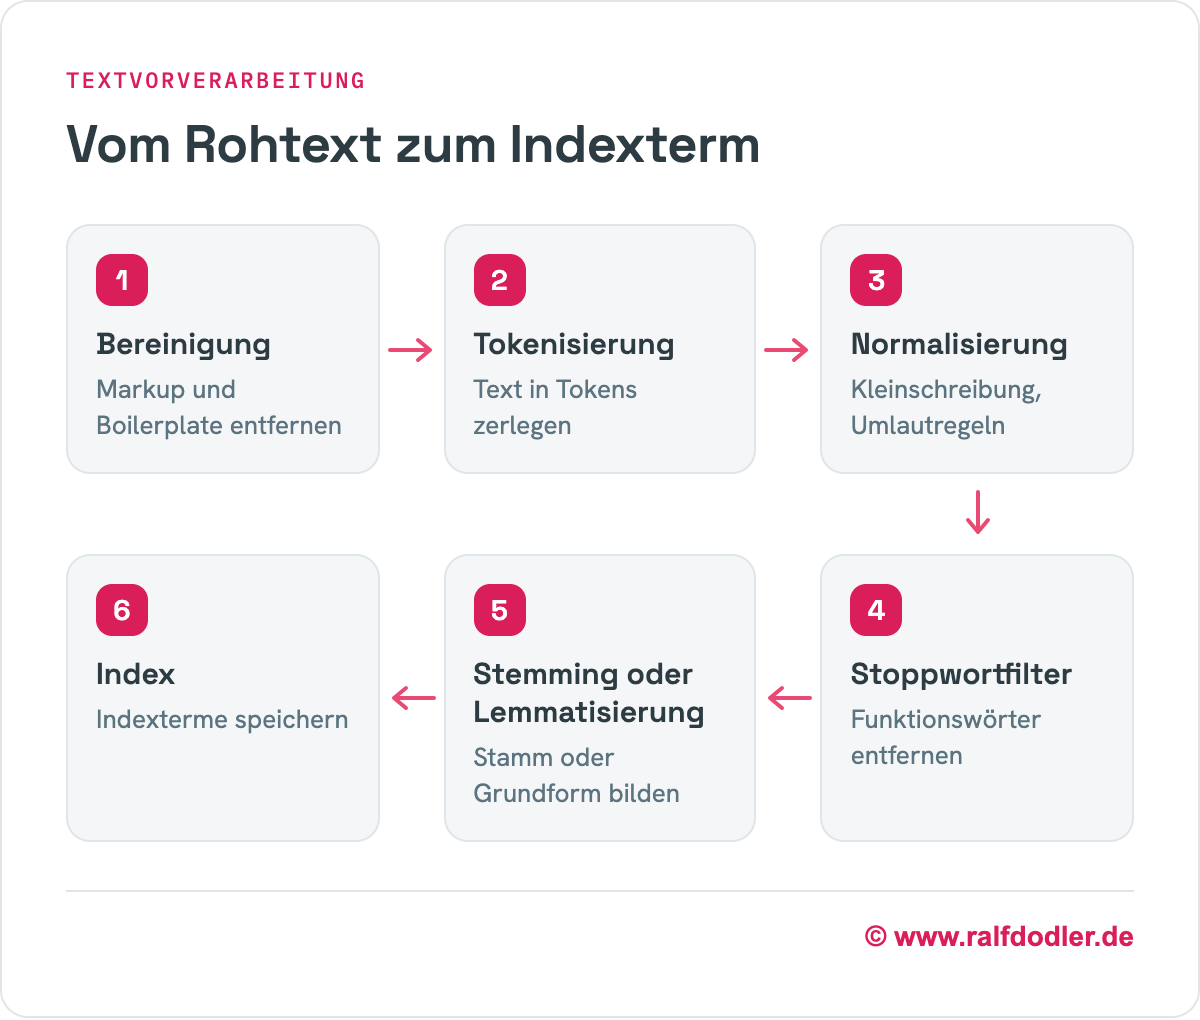
Die Kette läuft immer in derselben Reihenfolge. Zuerst entfernt das System Markup und Störzeichen. Dann zerlegt es den Text in Tokens, vereinheitlicht deren Schreibweise und filtert Funktionswörter. Am Ende reduziert es jedes Wort auf einen Stamm oder eine Grundform.
Welche Schritte umfasst die Textvorverarbeitung?
Die Textvorverarbeitung umfasst Bereinigung, Tokenisierung, Normalisierung, Stoppwortfilterung und Wortformreduktion. Die folgenden Abschnitte zeigen den ersten Schritt und eine Regel, die für die ganze Kette gilt: Anfragen durchlaufen dieselbe Verarbeitung wie Dokumente.
Bereinigung entfernt Markup
Die Bereinigung entfernt alles aus einem Dokument, was kein inhaltlicher Text ist. Dazu gehören HTML-Tags, Skripte, Navigationsmenüs, Footer und Cookie-Hinweise. Diese wiederkehrenden Seitenbestandteile heißen Boilerplate.
Zur Bereinigung gehört auch die Zeichenkodierung. Das System wandelt alle Texte in eine einheitliche Kodierung wie UTF-8 um. Die Unicode-Normalisierung sorgt zusätzlich dafür, dass ein „ä“ immer aus demselben Codepunkt besteht. Unicode kennt nämlich zwei Schreibweisen: ein fertiges „ä“ und ein „a“ mit nachgestelltem Trema-Zeichen.
Fehler in diesem Schritt verfälschen den gesamten Index. Bleibt Boilerplate stehen, erhalten Menübegriffe ein Gewicht, das ihnen inhaltlich nicht zusteht. Zerbrochene Umlaute erzeugen Terme, die keine Anfrage jemals trifft.
Anfragen durchlaufen dieselbe Pipeline
Suchsysteme verarbeiten Anfragen mit denselben Regeln wie Dokumente. Nur so treffen die Terme einer Anfrage auf die Terme im Index.
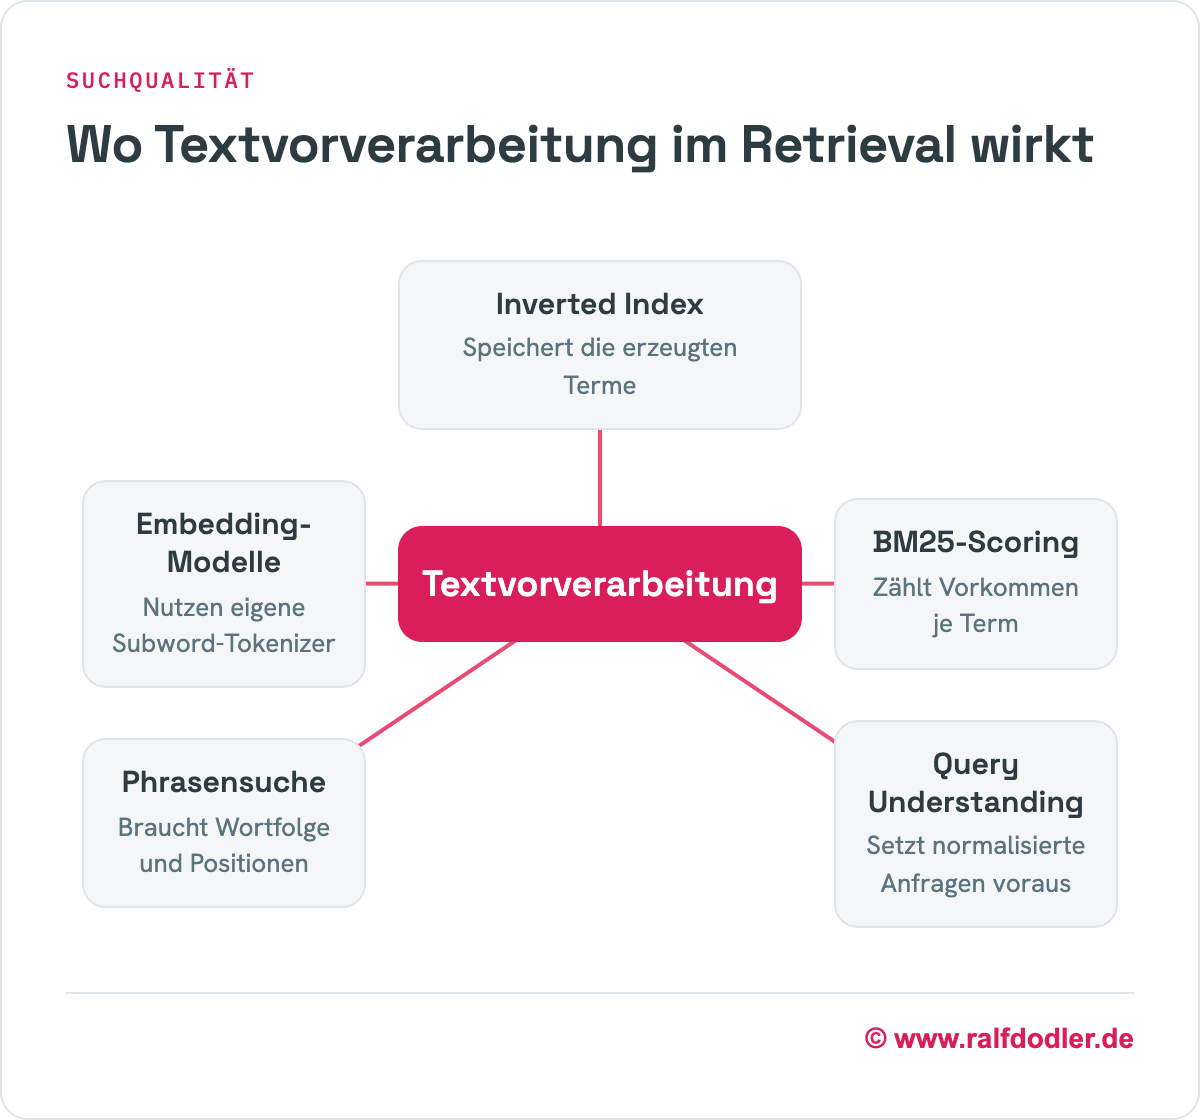
Ein Inverted Index verzeichnet zu jedem Term die Dokumente, in denen er vorkommt. Speichert der Index nur den Stamm „haus“, muss auch die Anfrage „Häuser“ zu „haus“ werden. Bleibt die Anfrage unverarbeitet, findet das System für „Häuser“ keinen Eintrag und liefert null Treffer.
Diese Symmetrie betrifft jede Stufe: Tokenisierung, Kleinschreibung, Umlautregeln, Stoppwörter und Stemming. Ändert ein Betreiber eine Regel, muss er den Index neu aufbauen. Auf der Anfrageseite ergänzt Query Understanding diese Verarbeitung um Intention und Kontext, setzt aber die Normalisierung der Terme voraus.
Was ist Tokenisierung?
Tokenisierung ist das Zerlegen eines Textes in einzelne Einheiten, die Tokens. Tokens sind meist Wörter, aber auch Zahlen, Satzzeichen oder Wortteile. Die folgenden Abschnitte zeigen, wo Wortgrenzen liegen, warum deutsche Komposita schwierig sind und wie Subword-Verfahren arbeiten.
Wortgrenzen bestimmen Tokens
Ein Tokenizer trennt Tokens an Wortgrenzen. Die einfachste Wortgrenze ist das Leerzeichen, dazu kommen Satzzeichen wie Punkt, Komma und Klammer.
Schwierig wird es bei Zeichen, die je nach Kontext trennen oder verbinden. Ein Bindestrich trennt in „Content-Strategie“ zwei Wörter, gehört in „E-Mail“ aber zum Wort. Ein Punkt beendet einen Satz, steht aber auch in „z. B.“, in Versionsnummern und in URLs. Zahlen mit Einheiten wie „5 kg“ oder Datumsangaben brauchen eigene Regeln.
Jede dieser Entscheidungen legt fest, welche Begriffe der Index kennt. Zerlegt der Tokenizer „E-Mail“ in „E“ und „Mail“, trifft die Anfrage „E-Mail“ nur noch einen Teil. Bleibt eine URL ungetrennt, findet niemand die Domain darin. Deshalb legen Suchsysteme diese Regeln je Sprache und je Datentyp fest.
Komposita erschweren Tokenisierung
Deutsche Komposita verbinden mehrere Wörter zu einem einzigen Token. „Suchmaschinenoptimierung“ enthält „Suchmaschine“ und „Optimierung“, steht aber ohne Leerzeichen da. Ein Tokenizer, der nur an Leerzeichen trennt, erzeugt daraus genau einen Term.
Für die Suche ist das ein Problem. Die Anfrage „Optimierung für Suchmaschinen“ trifft das Kompositum nicht, obwohl der Inhalt passt. Englische Texte schreiben dieselben Begriffe meist getrennt und haben dieses Problem kaum.
Die Dekomposition löst das. Sie zerlegt ein Kompositum anhand eines Wörterbuchs in seine Bestandteile und berücksichtigt Fugenelemente wie das „s“ in „Arbeitsplatz“. Viele Suchsysteme speichern dann das Kompositum und seine Teile. So treffen Anfragen mit und ohne Zusammenschreibung dasselbe Dokument. Die Tabelle zeigt typische Fälle.
| Fall | Beispiel | Übliche Behandlung |
|---|---|---|
| Bindestrich | Content-Strategie | Ganzes Wort und Teile als Tokens speichern |
| Apostroph | geht’s | Apostroph entfernen oder Form auflösen |
| Zahl mit Einheit | 5 kg | Zahl und Einheit als getrennte Tokens |
| Kompositum | Suchmaschinenoptimierung | Dekomposition per Wörterbuch |
| Abkürzung | z. B. | Punkte erhalten, nicht als Satzende werten |
Subword-Verfahren zerlegen Wortteile
Subword-Verfahren zerlegen Wörter in häufige Wortteile statt in ganze Wörter. Die bekanntesten Verfahren sind Byte Pair Encoding (BPE) und WordPiece.
Beide Verfahren lernen ein festes Vokabular aus einem großen Textkorpus. BPE beginnt mit einzelnen Zeichen und verschmilzt schrittweise die häufigsten Paare zu längeren Einheiten. Häufige Wörter bleiben dadurch ganz, seltene Wörter zerfallen in mehrere Teile. Das Prinzip ähnelt Zeichen-N-Grammen, die Wörter ebenfalls in überlappende Ausschnitte zerlegen.
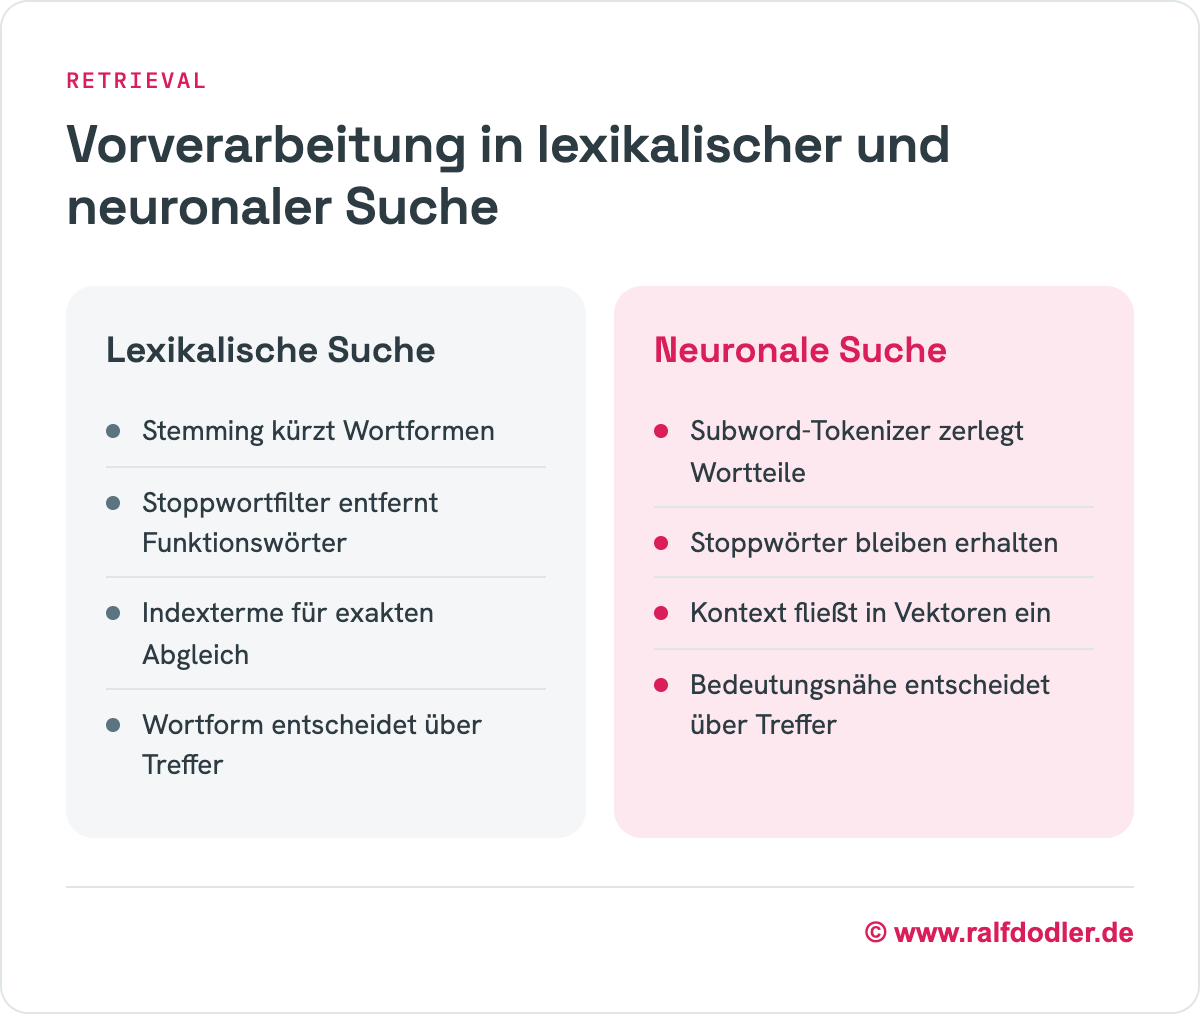
Transformer-Modelle wie BERT nutzen diese Tokenizer. Ein Transformer-Retriever kennt deshalb kein unbekanntes Wort: Jedes neue Wort lässt sich aus bekannten Teilen zusammensetzen. Die Wortgrenzen und Wortformen klassischer Pipelines spielen für diese Modelle eine geringere Rolle.
Was bedeutet Normalisierung im Information Retrieval?
Normalisierung bedeutet im Information Retrieval, verschiedene Schreibweisen desselben Begriffs auf eine einheitliche Form zu bringen. Die folgenden Abschnitte zeigen drei Normalisierungsschritte: Kleinschreibung, Umlautregeln und Stoppwortfilter.
Kleinschreibung gleicht Varianten an
Case Folding wandelt alle Buchstaben in Kleinbuchstaben um. „Suche“, „suche“ und „SUCHE“ werden dadurch zu einem einzigen Term.
Im Deutschen ist dieser Schritt besonders wirksam. Substantive stehen groß, dasselbe Wort steht am Satzanfang aber auch als Verb oder Adjektiv groß. Ohne Kleinschreibung zerfällt ein Begriff im Index in mehrere Einträge, und eine Anfrage trifft nur einen davon.
Case Folding hat einen Preis. Eigennamen und Akronyme verlieren ihre Unterscheidung von gewöhnlichen Wörtern. „Apple“ und „apple“ fallen zusammen, ebenso das Akronym „US“ und das Pronomen „us“ in englischen Texten. Manche Systeme behalten deshalb Großschreibung bei Wörtern, die vollständig groß geschrieben sind.
Umlautregeln vereinheitlichen Zeichen
Umlautregeln legen fest, wie ein Suchsystem „ä“, „ö“, „ü“ und „ß“ behandelt. Nutzer schreiben dieselben Wörter auf mehrere Arten: „Müller“, „Mueller“ oder „Muller“.
Suchsysteme wählen meist eine von zwei Regeln. Die erste ersetzt „ä“ durch „ae“, „ö“ durch „oe“, „ü“ durch „ue“ und „ß“ durch „ss“. Die zweite entfernt die Punkte und macht aus „ä“ ein „a“. Der Snowball-Stemmer für Deutsch nutzt die zweite Regel. Für andere Diakritika gilt dasselbe Prinzip: „Café“ wird zu „cafe“.
Die Regel muss auf Dokumente und Anfragen gleich wirken. Speichert der Index „mueller“ und verarbeitet die Anfrage „Müller“ zu „muller“, scheitert der Abgleich. Gute Systeme bilden deshalb alle Schreibweisen auf eine gemeinsame Form ab.
Stoppwortlisten filtern Funktionswörter
Stoppwortlisten entfernen Funktionswörter, die in fast jedem Text vorkommen. Dazu gehören Artikel wie „der“ und „die“, Präpositionen wie „am“ und „mit“ sowie Hilfsverben wie „wurden“.
Diese Wörter tragen wenig Unterscheidungskraft. Ein Term, der in jedem Dokument steht, trennt relevante nicht von irrelevanten Dokumenten. Gewichtungsverfahren wie TF-IDF geben solchen Termen ohnehin ein niedriges Gewicht. Ihre Entfernung verkleinert den Index zusätzlich.
Stoppwortlisten haben Nebenwirkungen. Phrasen wie „Sein oder Nichtsein“ bestehen fast nur aus Stoppwörtern. Fragewörter wie „wie“ und „warum“ zeigen die Suchintention an. Moderne Systeme entfernen Stoppwörter deshalb sparsam oder speichern sie mit. Die Tabelle zeigt, wie ein Satz die bisherigen Schritte und die Wortformreduktion durchläuft.
| Schritt | Ergebnis |
|---|---|
| Rohtext | Die Häuser am Fluss wurden renoviert. |
| Bereinigung und Tokenisierung | Die · Häuser · am · Fluss · wurden · renoviert |
| Kleinschreibung | die · häuser · am · fluss · wurden · renoviert |
| Stoppwortfilter | häuser · fluss · renoviert |
| Stemming (Snowball) | haus · fluss · renoviert |
| Lemmatisierung | Haus · Fluss · renovieren |
Was ist Stemming?
Stemming ist ein regelbasiertes Verfahren, das Wörter durch das Abschneiden von Endungen auf einen gemeinsamen Wortstamm kürzt. Der Stamm muss kein echtes Wort sein, er muss nur für alle Formen gleich sein. Die folgenden Abschnitte erklären die Suffixregeln und die typischen Fehler.
Suffixregeln erzeugen Wortstämme
Ein Stemmer kürzt Wörter anhand einer Liste von Endungen. Er entfernt etwa „-en“, „-er“, „-es“ oder „-ung“, wenn das Wort danach lang genug bleibt.
Der bekannteste Algorithmus ist der Porter-Stemmer, den Martin Porter 1980 für Englisch veröffentlicht hat. Porter entwickelte später Snowball, eine Sprache für Stemming-Regeln. Snowball-Stemmer gibt es für Deutsch, Französisch, Spanisch und viele weitere Sprachen. Jede Sprache braucht einen eigenen Regelsatz, weil sich Endungen und Flexion unterscheiden.
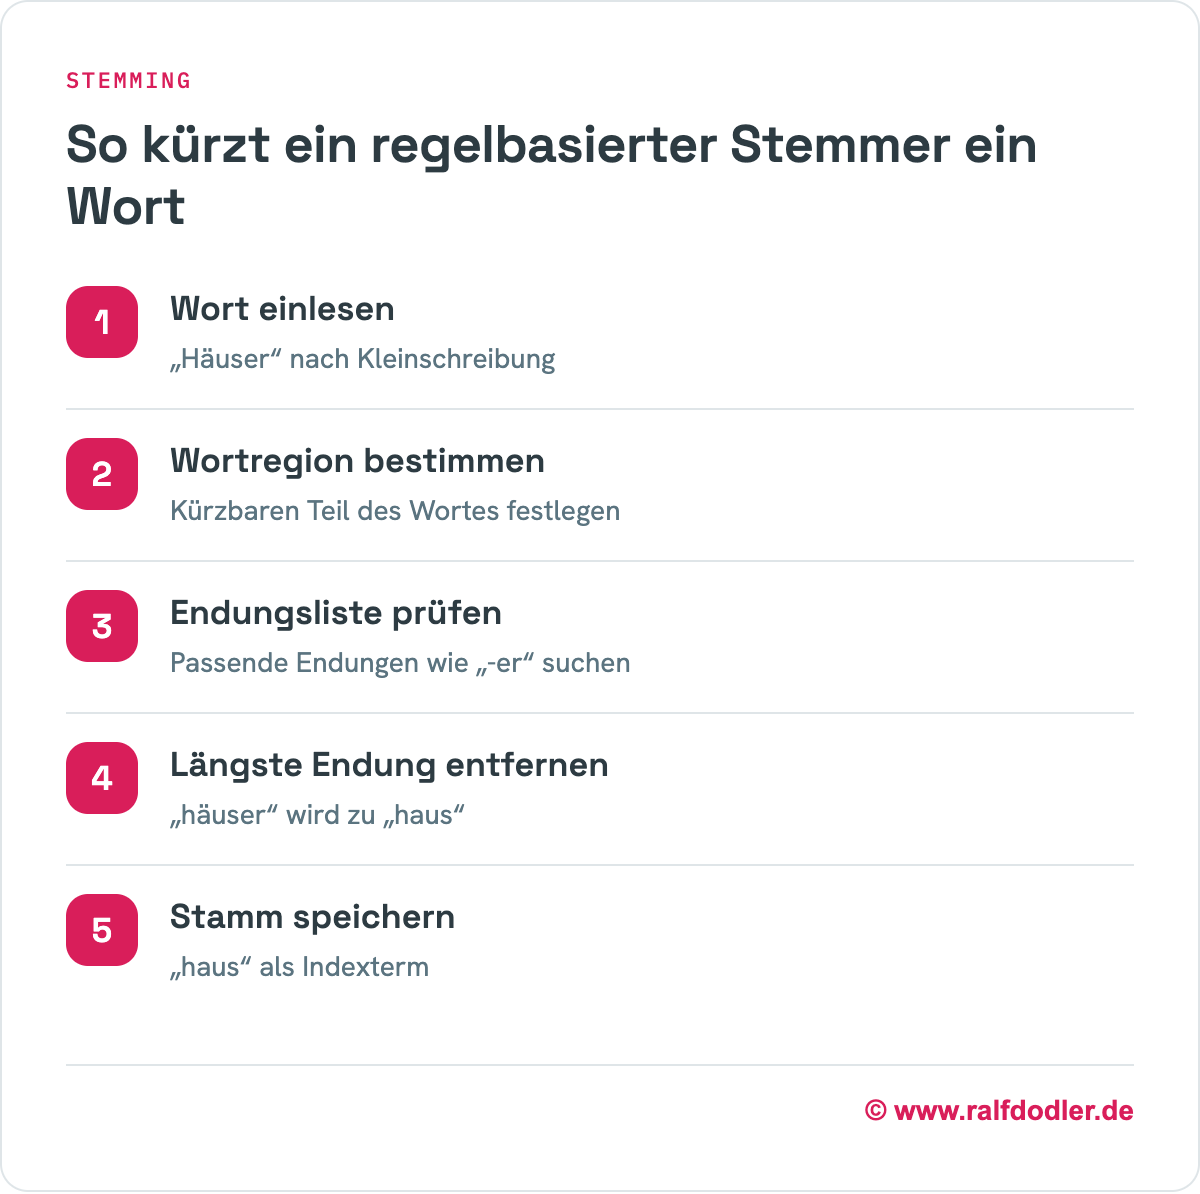
Ein Stemmer prüft zuerst, welcher Teil des Wortes gekürzt werden darf. Diese Wortregion schützt kurze Wörter davor, dass von ihnen nichts übrig bleibt. Danach sucht er die längste passende Endung und entfernt sie. Der deutsche Snowball-Stemmer macht so aus „Häuser“, „Haus“ und „Hauses“ den Stamm „haus“. Er arbeitet ohne Wörterbuch und verarbeitet Millionen Wörter in Sekunden.
Stemmer erzeugen Fehlzuordnungen
Stemmer machen zwei Arten von Fehlern: Überstemming und Unterstemming. Beide entstehen, weil Regeln die Bedeutung eines Wortes nicht kennen.
Überstemming kürzt Wörter mit verschiedener Bedeutung auf denselben Stamm. Der Porter-Stemmer macht aus „universe“, „university“ und „universal“ den Stamm „univers“. Eine Suche nach Universitäten findet dadurch auch Texte über das Weltall.
Unterstemming lässt Formen desselben Wortes getrennt. Der deutsche Snowball-Stemmer macht aus „renovieren“ den Stamm „renovi“, aus „renoviert“ aber „renoviert“. Unregelmäßige Formen wie „ging“ und „gehen“ bleiben ebenfalls getrennt. Eine Anfrage findet dann nur einen Teil der passenden Dokumente.
Was ist Lemmatisierung?
Lemmatisierung ist ein wörterbuchbasiertes Verfahren, das jede Wortform auf ihre Grundform zurückführt, das Lemma. Anders als ein Stamm ist ein Lemma immer ein echtes Wort. Die folgenden Abschnitte zeigen, woher die Grundformen kommen und warum die Wortart entscheidet.
Wörterbücher liefern Lemmata
Ein Lemmatisierer schlägt jede Wortform in einem morphologischen Wörterbuch nach. Das Wörterbuch verzeichnet zu jeder Form die Grundform: „Häuser“ gehört zu „Haus“, „ging“ zu „gehen“, „besser“ zu „gut“.
Die morphologische Analyse erkennt dabei Kasus, Numerus, Tempus und Person. Sie weiß, dass „gegangen“ ein Partizip von „gehen“ ist. Ein Stemmer kann diese Beziehung nicht herstellen, weil zwischen den Formen keine gemeinsame Endung liegt.
Für die Suche bedeutet das saubere Indexterme. Unregelmäßige Verben, Pluralformen mit Umlaut und Steigerungsformen landen beim richtigen Begriff. Der Preis ist ein großes Wörterbuch je Sprache, das neue Wörter und Fachbegriffe erst kennen muss.
Wortarten steuern Lemmatisierung
Die Lemmatisierung braucht die Wortart jedes Wortes, weil dieselbe Form zu verschiedenen Lemmata gehören kann. „Wagen“ ist als Substantiv das Fahrzeug und als Verb eine Form von „wagen“. „Sucht“ ist als Substantiv eine Abhängigkeit und als Verb eine Form von „suchen“.
Ein Part-of-Speech-Tagger bestimmt die Wortart aus dem Satzkontext. Erst mit dieser Information wählt der Lemmatisierer das richtige Lemma. Fehler des Taggers führen deshalb direkt zu falschen Grundformen.
Diese Analyse kostet Rechenzeit. Ein Stemmer betrachtet jedes Wort einzeln, ein Lemmatisierer analysiert ganze Sätze. Bei großen Indizes mit Milliarden Wörtern wird dieser Unterschied zum Kostenfaktor.
Was unterscheidet Stemming und Lemmatisierung?
Stemming kürzt Wörter per Regel auf einen Stamm, Lemmatisierung führt sie per Wörterbuch auf eine Grundform zurück. Beide Verfahren verfolgen dasselbe Ziel: Verschiedene Wortformen sollen denselben Indexterm treffen.
Stemming ist schnell, sprachunabhängig im Aufbau und braucht keine Wörterbücher. Dafür erzeugt es Kunstwörter und Fehlzuordnungen. Lemmatisierung liefert echte Wörter und erkennt unregelmäßige Formen, braucht aber Sprachwissen und mehr Rechenzeit.
In der Praxis nutzen viele Suchsysteme Stemming für den Index und kombinieren es mit Wörterbüchern für Ausnahmen. Lemmatisierung kommt dort zum Einsatz, wo Präzision wichtiger ist als Geschwindigkeit, etwa bei der Analyse von Texten oder in Fachsuchen.
| Kriterium | Stemming | Lemmatisierung |
|---|---|---|
| Ergebnis | Wortstamm, oft kein echtes Wort (haus, renovi) | Grundform als echtes Wort (Haus, renovieren) |
| Methode | Regeln für Endungen | Wörterbuch und morphologische Analyse |
| Sprachwissen | Regelsatz je Sprache | Wörterbuch und Wortartbestimmung je Sprache |
| Geschwindigkeit | Sehr hoch, Wort für Wort | Niedriger, Satz für Satz |
| Fehlerbild | Überstemming und Unterstemming | Unbekannte Wörter, falsche Wortart |
| Einsatz | Große Suchindizes | Textanalyse, Fachsuche, Wissensgraphen |
Wie beeinflusst Textvorverarbeitung die Suchqualität?
Textvorverarbeitung beeinflusst die Suchqualität, weil sie festlegt, welche Dokumente für eine Anfrage überhaupt in Frage kommen. Ein Text, dessen Terme nicht zur Anfrage passen, ist für das System nicht abrufbar. Das Generative Authority Model (GAM) von Ralf Dodler beschreibt diese Abrufbarkeit als Retrieval Activation. Die Vorverarbeitung wirkt dabei auf mehrere Stufen der Retrieval Pipeline zugleich.
Normalisierung erhöht Recall
Normalisierung erhöht den Recall, also den Anteil der relevanten Dokumente, den eine Suche findet. Je mehr Wortformen auf denselben Indexterm fallen, desto mehr passende Dokumente trifft eine Anfrage.
Ohne Normalisierung findet die Anfrage „Haus“ nur Dokumente mit genau dieser Form. Mit Kleinschreibung, Umlautregeln und Stemming trifft sie auch „Häuser“, „Hauses“ und „HAUS“. Bewertungsverfahren wie BM25 zählen dann alle Vorkommen als denselben Term.
Davon profitiert besonders das Sparse Retrieval, das Dokumente über exakte Termübereinstimmung findet. Es kennt keine Bedeutungsähnlichkeit. Jede Wortform, die die Vorverarbeitung nicht zusammenführt, ist für Sparse Retrieval ein anderer Begriff.
Starke Reduktion senkt Precision
Starke Reduktion senkt die Precision, also den Anteil der relevanten Dokumente unter allen Treffern. Je aggressiver ein System Wörter kürzt, desto mehr Bedeutungen fallen auf denselben Term.
Überstemming ist der deutlichste Fall. Wenn „university“ und „universe“ denselben Stamm haben, mischt die Ergebnisliste Hochschulen und Astronomie. Auch Case Folding und Stoppwortfilter verlieren Unterscheidungen, etwa zwischen einem Firmennamen und einem gewöhnlichen Wort.
Das Ranking verliert dadurch Trennschärfe. Gewichtungsverfahren zählen Vorkommen, die inhaltlich nichts miteinander zu tun haben. Suchsysteme wägen deshalb ab: Leichte Stemmer erhalten mehr Precision, aggressive Stemmer gewinnen mehr Recall. Viele Systeme speichern zusätzlich die Originalform, damit exakte Treffer im Ranking vorn landen.
Neuronale Modelle verlagern Vorverarbeitung
Neuronale Retrieval-Modelle ersetzen Stemming und Stoppwortlisten durch eigene Subword-Tokenizer. Sie verarbeiten Text weitgehend so, wie er geschrieben steht.
Ein Dense Retriever wandelt Anfrage und Dokument in Embeddings um, also Vektoren, die Bedeutung repräsentieren. Der Kontext eines Wortes fließt in diese Vektoren ein. „Häuser“ und „Haus“ liegen im Vektorraum nah beieinander, ohne dass ein Stemmer sie zusammenführt. Stoppwörter bleiben erhalten, weil sie zur Bedeutung eines Satzes beitragen.
Die klassische Vorverarbeitung verschwindet dadurch nicht. Hybrid Search kombiniert lexikalische und neuronale Suche und braucht beide Wege: einen normalisierten Index für exakte Begriffe und Embeddings für Bedeutungsnähe. Beide Verarbeitungsketten laufen dann parallel.
Was bedeutet Textvorverarbeitung für Inhalte?
Textvorverarbeitung bedeutet für Inhalte, dass ihre Wortwahl über die Abrufbarkeit mitentscheidet. Die Pipeline gleicht Wortformen an, aber keine verschiedenen Begriffe. Die folgenden Abschnitte zeigen zwei Folgen für das Schreiben.
Einheitliche Terminologie stabilisiert Matching
Ein Fachbegriff je Konzept erleichtert den Abgleich zwischen Anfrage und Text. Stemming führt „Indexierung“ und „Indexierungen“ zusammen, „Indexierung“ und „Indizierung“ aber nicht.
Wer für dasselbe Konzept wechselnde Begriffe nutzt, verteilt die Termhäufigkeit auf mehrere Indexterme. Jeder einzelne Term erscheint dann seltener, und das Dokument verliert bei der Gewichtung an Stärke. Ein stabiler Fachbegriff bündelt dagegen alle Vorkommen.
Definitionen nennen den Begriff am besten in der Grundform. Die Grundform ist die Form, die Nutzer in Anfragen am häufigsten verwenden, und sie ist zugleich das Lemma. Diese Konsistenz ist ein Kern der semantischen Optimierung, die Inhalte für Suchsysteme und Sprachmodelle eindeutig macht.
Schreibvarianten erweitern Abdeckung
Schreibvarianten erweitern die Abdeckung, wenn Nutzer denselben Begriff auf mehrere Arten suchen. Die Vorverarbeitung führt nicht jede Variante zusammen.
Komposita sind der wichtigste Fall. „Suchmaschinenoptimierung“ und „Optimierung für Suchmaschinen“ treffen nur dann dasselbe Dokument, wenn das System Komposita zerlegt. Ein Text, der beide Formen natürlich verwendet, trifft beide Anfragen sicher. Dasselbe gilt für englische und deutsche Fachbegriffe wie „Retrieval“ und „Abruf“.
Suchsysteme gleichen fehlende Varianten teilweise über Query Expansion aus, die eine Anfrage um verwandte Begriffe erweitert. Ein Text, der die gängigen Varianten selbst enthält, hängt davon nicht ab.
Verwandte Themen
Textvorverarbeitung ist die erste Stufe lexikalischer Suchsysteme und steht in enger Beziehung zu Indexstrukturen, Gewichtungsverfahren und neuronalen Modellen. Während die Indexierung die Terme speichert, bestimmt die Vorverarbeitung, welche Terme entstehen.
Wichtige verwandte Themen sind:
- Information Retrieval
- Indexierung
- Inverted Index
- N-Gramm
- TF-IDF
- Query Understanding
- Embeddings
- Vektorraummodell und Ähnlichkeitsmaße
FAQ zur Textvorverarbeitung
Braucht Retrieval-Augmented Generation noch Stemming?
Retrieval-Augmented Generation braucht Stemming, sobald ihr Retrieval eine lexikalische Komponente enthält. Rein vektorbasierte RAG-Systeme verarbeiten Text mit dem Subword-Tokenizer des Embedding-Modells und verzichten auf Stemming. Hybride RAG-Systeme nutzen für ihren lexikalischen Index weiterhin Stemming, damit exakte Begriffe in allen Wortformen abrufbar bleiben.
Wie verarbeiten Suchsysteme mehrsprachige Texte?
Suchsysteme verarbeiten mehrsprachige Texte, indem sie zuerst die Sprache erkennen und dann eine sprachspezifische Pipeline anwenden. Die Spracherkennung wertet Zeichenmuster aus und ordnet einem Dokument oder Abschnitt eine Sprache zu. Danach gelten Tokenizer, Stoppwortliste und Stemmer dieser Sprache, weil Endungen und Funktionswörter je Sprache verschieden sind.
Schadet Stoppwortentfernung der Phrasensuche?
Stoppwortentfernung schadet der Phrasensuche, weil Phrasen ihre Bedeutung aus der genauen Wortfolge beziehen. Ohne Stoppwörter fehlen dem Index Wörter, aus denen Phrasen bestehen, und die Abstände zwischen den übrigen Wörtern stimmen nicht mehr. Suchsysteme mit Phrasensuche speichern Stoppwörter deshalb mit ihren Positionsdaten im Index und filtern sie nur beim Ranking.
Worin unterscheidet sich Textvorverarbeitung von Query Expansion?
Textvorverarbeitung vereinheitlicht die Form vorhandener Wörter, Query Expansion ergänzt eine Anfrage um zusätzliche Begriffe. Textvorverarbeitung wirkt gleich auf Dokumente und Anfragen und führt Wortformen auf einen gemeinsamen Term zurück. Query Expansion wirkt nur auf die Anfrage und fügt Synonyme oder verwandte Begriffe hinzu, die im ursprünglichen Text nicht stehen.
Zentrale Erkenntnisse von Ralf Dodler zur Textvorverarbeitung
„Was die Textvorverarbeitung nicht zusammenführt, existiert für eine lexikalische Suche als zwei verschiedene Begriffe.“
– Ralf Dodler, Generative SEO-Stratege
- Textvorverarbeitung überführt Rohtext über Bereinigung, Tokenisierung, Normalisierung und Wortformreduktion in Indexterme.
- Anfragen und Dokumente müssen dieselbe Verarbeitung durchlaufen, sonst findet der Index keine Treffer.
- Deutsche Komposita brauchen eine Dekomposition, damit zusammengeschriebene und getrennte Begriffe dasselbe Dokument treffen.
- Stemming kürzt Wörter per Regel auf einen Stamm und erzeugt dabei Über- und Unterstemming.
- Lemmatisierung führt Wortformen per Wörterbuch und Wortart auf echte Grundformen zurück.
- Normalisierung erhöht den Recall, starke Reduktion senkt die Precision.
- Neuronale Retrieval-Modelle ersetzen Stemming durch Subword-Tokenizer, Hybrid Search braucht beide Verarbeitungsketten.
- Ein einheitlicher Fachbegriff je Konzept bündelt die Termhäufigkeit auf einen Indexterm.
Ralf Dodler ist Generative SEO-Stratege und Entwickler des Generative Authority Model (GAM), eines strategischen Vier-Ebenen-Frameworks zur Positionierung von Marken, Organisationen und Experten als vertrauenswürdige, zitierfähige Entitäten in AI-Search-Ökosystemen. Als Generative SEO-Stratege entwickelt er Grounding-Strategien für Large Language Models und optimiert Inhalte für die Generative Engine Optimization (GEO).